Статья Фэнчуня Мяо опубликована в Open Education Research, том 30, № 1 за 2024 год, как вторая интерпретация Руководства ЮНЕСКО по генеративному ИИ в образовании и исследованиях. Это издание сохраняет полный охват оригинала, включая три иллюстрации, двадцать семь ссылок и исходные англоязычные сведения, добавляя структурированные разделы и доступные текстовые таблицы. Технические суждения, статистика и анализ политики читаются в контексте написания в 2023 году; исправления названий, чисел и правовых описаний документированы в редакционных примечаниях.
Фэнчунь Мяо — организации 1 и 2
1. Национальный инженерно-исследовательский центр сетевого обучения и интеллектуальных технологий, Пекинский педагогический университет.
2. Штаб-квартира ЮНЕСКО.
Аннотация. Это вторая статья цикла, посвящённого интерпретации Руководства ЮНЕСКО по генеративному ИИ в образовании и исследованиях. В ней рассматриваются основные противоречия, связанные с генеративным ИИ и его образовательными применениями. Анализ технических ограничений на разных этапах работы выявляет проблемы усугубления бедности данных, технологической непрозрачности и пробелов национального регулирования, несанкционированного сбора обучающих данных, необъяснимости архитектур моделей, понимания реального мира фундаментальными моделями, загрязнения интернета сгенерированным контентом, проецирования доминирующих ценностей и распространения незаконных дипфейков.
В статье утверждается, что генеративный ИИ может глубоко затронуть такие образовательные ценности, как равенство, инклюзия, субъектность учащихся, разнообразие ценностей, языков и культур, а также плюрализм построения знаний. Именно эти ценности должны стать отправной точкой оценки его образовательной пригодности. Разработчикам политики и практикам предлагается следовать принципу «приоритет регулирования, обеспечение инклюзии, направление практического применения», усиливая регулирование и правоприменение во всей системе для создания безопасных, надёжных, самостоятельно контролируемых и локально подходящих образовательных экосистем генеративного ИИ. Затем надлежащее образовательное использование следует поддерживать развитием компетенций и практическими рекомендациями.
Ключевые слова: генеративный искусственный интеллект; обработка контента; источники обучающих наборов данных; справедливость, инклюзия, языковое и культурное разнообразие.
Введение
В ноябре 2022 года OpenAI выпустила ChatGPT, открыв новый этап перехода генеративного ИИ от исследований к коммерческому и массовому применению. Первоначальный ChatGPT основывался на серии GPT-3.5; обозначение «ChatGPT-3» в оригинале здесь исправлено по сведениям разработчика о запуске, как поясняется в редакционных примечаниях. Статья объединяет последствия и регуляторные реакции примерно за первый год после выпуска в четыре группы.
1. Монополия и разнообразие. В статье OpenAI, Google и Meta описываются как компании, создававшие вертикально доминирующие позиции, охватывающие фундаментальные модели, сетевую инфраструктуру и обработку текста, изображений, аудио и видео. Другие крупные компании и сообщества открытых моделей стремились развивать открытые фундаментальные модели, расширять выбор платформ и языковое и культурное разнообразие через конкурирующие исследования и развитие экосистем.
2. Применение и замещение. Генеративный ИИ быстро распространялся в коммерческой деятельности, ускоряя автоматизацию рабочих мест в затронутых отраслях.
3. Противоречия и управление. Вопросы безопасности и этики переходили от теоретических опасений к реальным судебным делам. Уверенность в преобразующем потенциале соседствовала с тревогой о человеческих последствиях, ускоряя целевые законодательные инициативы в странах и юрисдикциях, включая Китай, США и Европейский союз.
4. Видение и реальность. Быстро возникавший генеративный ИИ нарушал привычный порядок и менял образование и другие социальные услуги, тогда как между этими изменениями и взвешенной оценкой образовательной пригодности и практической полезности для местных учащихся, особенно несовершеннолетних, оставался значительный разрыв. Общественные мнения о возможных последствиях для безопасности и этики оставались разделёнными.
Руководство ЮНЕСКО по генеративному ИИ в образовании и исследованиях, опубликованное в сентябре 2023 года и далее именуемое Руководством (Miao, 2023), прослеживало принципы работы технологии и систематически выделяло восемь основных противоречий. Оно рассматривало их образовательные последствия и предлагало меры государственного управления, образовательную политику и практическую структуру взаимодействия человека и машины, соответствующую участвующим людям.
Будучи второй интерпретацией Руководства, исследование систематически рассматривает противоречия генеративного ИИ и образования, определяя управленческие меры и практические рекомендации по их причинам и ответственным участникам. Интерпретация опирается на три взаимосвязанных предположения:
Во-первых, инновации в ИИ, безопасность и надёжность, а также инклюзивное и равноправное общественное применение не должны образовывать трилемму. Все три цели должны развиваться совместно и взаимно усиливать друг друга.
Во-вторых, наиболее прямыми и глубокими исследование считает угрозы образовательному равенству и инклюзии, субъектности учащихся, разнообразию ценностей, языков и культур и плюрализму построения знаний. Поэтому эти ключевые ценности должны стать отправной точкой анализа образовательной пригодности генеративного ИИ.
В-третьих, образовательные применения должны следовать логике «приоритет регулирования, обеспечение инклюзии, направление практического применения».
I. Технические истоки противоречий
Обсуждение противоречий образовательного генеративного ИИ должно опираться на принципы работы технологии, её ограничения и наблюдаемые и возможные социальные последствия.
1. Принципы работы, источники обучающих данных и языковое распределение
Руководство определяет генеративный ИИ через имитацию ИИ символических систем, посредством которых представляется человеческое мышление: он автоматически создаёт контент в ответ на запросы, выраженные такими системами. Его возможности распознавания закономерностей и производства контента усиливались в тексте, речи, звуках, изображениях, видео и программном коде. В изложении статьи генерация текста использует искусственные нейронные сети и модели на архитектуре Transformer, обычно называемые большими языковыми моделями: системы глубокого обучения, обучаемые на информации с веб-страниц, из обсуждений в социальных сетях и других сетевых источников.
Генеративные предобученные модели текста или речи усваивают синтаксические закономерности обучающих наборов и приобретают способность отвечать на запросы, многократно применяя эти закономерности в циклах обучения, проверки и оптимизации. Основные этапы следующие:
1. Разделить запрос на токены, которые ИИ способен обработать, и передать их генеративному предобученному трансформеру. Здесь используется термин «токен» вместо неточного слова «байт» в китайском оригинале.
2. На основе языковых закономерностей, выявленных в обучающих данных, предсказать вероятность определённых слов или фраз в контексте. Статистические предсказания объединяют слова и синтаксические отношения в связные ответы и определяют наиболее вероятные следующие слова или фразы.
3. Преобразовать предсказанные слова или фразы в читаемый текст либо понятную речь. Защитные механизмы отфильтровывают явно незаконные или иные неподходящие результаты, а дополнительная обработка улучшает синтаксис и понятность, приближая их к человеческой речи. Процесс повторяется до формирования полного ответа.
Генерацию изображений и музыки статья объясняет главным образом через генеративно-состязательные сети (GAN), которые могут сочетаться с вариационными автоэнкодерами. Она также отмечает диффузионные модели как другой подход к генерации изображений. GAN состоит из двух конкурирующих компонентов: генератора и дискриминатора. В ответ на запрос генератор определяет сочетания визуальных или музыкальных элементов и создаёт исходное изображение либо музыкальный фрагмент. Дискриминатор сравнивает его с реальными примерами. Затем генератор корректирует параметры по результатам сравнения. Многократные итерации обучения делают сгенерированные изображения или музыку всё более реалистичными.
Возможности генеративного предобученного трансформера зависят от архитектуры, методов обучения, качества и объёма данных предобучения и параметров модели. Параметры — числовые значения, определяющие обработку входных данных и создание выходных результатов нейронной сетью и кодирующие усвоенные при обучении признаки. Их определение и масштаб влияют на производительность. GPT-3 использовала около 175 миллиардов параметров. Оригинал повторяет неподтверждённое утверждение о «1,8 триллиона» параметров GPT-4; официальный технический отчёт GPT-4 размер модели не раскрывал, как объясняют редакционные примечания. Тогдашний набор моделей включал продукты ChatGPT от OpenAI; Alpaca, созданную в Стэнфорде дообучением LLaMA от Meta; модели Llama от Meta; Bard от Google, тогда основанный на PaLM 2; и мультимодальную Gemini.
Источники обучения включали собранные обходом веб-страницы, обсуждения социальных сетей, книги электронных библиотек и энциклопедии. Для GPT-3 статья приводит оценку корпуса около 1 ТБ (Thompson, 2023): примерно 61,75 % составляли материалы Common Crawl, собранные в интернете с 2012 года; 18,86 % — публикации и обсуждения Reddit более чем с тремя положительными голосами; 15,9 % — книги Library Genesis и Smashwords; 3,49 % — Википедия. Это исторические оценки источников статьи, а не описание нынешнего ChatGPT. Текст подчёркивает преобладание языков США и Европы в тогдашних ведущих моделях: в упомянутом корпусе GPT-3 английский составлял около 92,65 %, другие европейские языки — более 5 %, китайский — менее 0,1 %.
В Llama 2 от Meta доля английского была 89,7 %, китайского — 0,13 %, а остальные пятнадцать ведущих языков почти не изменились (Touvron et al., 2023). Быстрый рост данных и параметров требовал большей высокопроизводительной вычислительной мощности. Для 2012–2019 годов статья приводит период удвоения вычислений, используемых для обучения ведущих моделей ИИ, в три-четыре месяца (Стэнфордский университет, 2019).
2. Совместное развитие обработки контента и возможные пределы технологической категории
Исследование описывает совместные достижения основных и вспомогательных технологий: сочетание методов глубокого обучения, оптимизацию архитектур, совершенствование наборов параметров масштаба сотен миллиардов, динамическое накопление обучающих данных с разных платформ и рост вычислительной мощности для огромных массивов данных. Вместе они способны вызвать «эффект неконтролируемого ускорения». Во-первых, прогресс обработки и представления информации в разных символических системах расширяет технические возможности и ускоряет работы над чипами ИИ, супервычислениями и моделями обработки данных. Фундаментальный характер этих достижений объясняет широкое принятие термина «фундаментальные модели», предложенного исследователями Стэнфорда в 2021 году (Bommasani, 2021).
Во-вторых, генеративный ИИ менял браузеры, поисковые системы и цифровую инфраструктуру, становясь важной точкой контроля национальной безопасности данных и личной приватности и создавая давление в пользу обновления регулирования и систем безопасности. В-третьих, он даёт инструменты производительности экономической и социальной деятельности, прямые или косвенные цели которой включают создание или синтез контента, с потенциально большими переменами производства. Однако автор считает, что его способность повысить эффективность и преобразовать такие сферы, как образование, чьи цели шире производства контента, может быть существенно ограниченной.
Рассматривая известные тогда технические подходы, автор характеризует достижения нейронных сетей как статистическую подгонку кривых, отличную от человеческого рассуждения, объединяющего временные, пространственные и причинные отношения (Pearl и Mackenzie, 2018). Если глубокое обучение является подходящим вычислительным путём к решению задач по-человечески, дальнейший прогресс со временем может вызвать неконтролируемое ускорение за пределами обработки контента: предполагаемую сингулярность, при которой ИИ превзойдёт человеческий интеллект и будет развиваться относительно независимо от человеческого контроля.
Но автор полагает, что известные тогда принципы фундаментальных моделей, по-видимому, оставались в пределах синтеза контента, обработки символических представлений и преобразования форматов, не образуя технического пути к человеческому пониманию. В этой интерпретации они рискуют совершить «категориальную ошибку» (Bishop, 2021). Открытым оставался вопрос, являются ли наблюдаемые достижения скачком производительности перед подобным категориальным барьером.
II. Основные противоречия генеративного ИИ
Статья понимает эти противоречия как человеческие опасения, возникающие при взаимодействии человека и машины, и рассматривает их в техническом и гуманистическом измерениях. Техническое измерение следует жизненному циклу системы ИИ: производство и хранение данных; доступ к данным и оборудованию обработки и контроль над ними; наблюдаемые последствия предсказаний и решений на основе данных и алгоритмов; и воплощённый ИИ, включая интеллектуальные интерфейсы и устройства. Гуманистическое измерение охватывает индивидуальное существование, социальное взаимодействие, национальное управление и отношения со средой и экосистемами. Его взаимосвязанные уровни включают отдельных людей, взаимодействующие группы, отношения, организованные как суверенные государства, и взаимодействия людей с окружением (Miao, 2022).
До масштабного внедрения пользователи должны изучать сбор и использование обучающих данных, базовые архитектуры и результаты, основанные на закономерностях, оценивая непосредственные угрозы и возможные последствия для людей, обществ и стран.
1. Извлечение производительности данных: усиление бедности данных и цифровой бедности
Автор считает опубликованные в Китае в 2022 году ЦК КПК и Государственным советом Мнения о создании базовых систем данных для более полного использования данных как фактора производства юридической вехой эпохи защиты собственности и прав на данные. С этой точки зрения бесплатный сбор данных людей и компаний и извлечение прибыли из обученных на них моделей выводят на первый план прежде менее заметные противоречия трансграничного и межотраслевого извлечения ценности данных.
Доступ к качественным данным, их применение и непрерывное создание качественных сетевых и преобразованных данных стали важными условиями экономического развития стран и цифровых возможностей людей. Страны без доступа к данным, возможностей их извлечения или супервычислений и люди, не способные платить за приложения на основе данных, сталкиваются с «бедностью данных» (Marwala, 2023). По мнению автора, обучение фундаментальных моделей на бесплатно собранных данных с последующей платой за услуги может усиливать эту бедность. Такое производство требует трёх условий: инноваций в архитектурах и методах обучения ИИ, очень больших наборов данных и супервычислительной мощности. В рассматриваемый период автор полагал, что одновременно ими обладали лишь США, Китай, ЕС и небольшое число крупнейших технологических компаний.
Бедные данными страны всё больше отставали и исключались из основных исследований фундаментальных моделей. Более широкое внедрение ускоряет создание данных и технические итерации у лидеров, укрепляя цикл цифрового разрыва.
Для обращения этого цикла страны должны выявлять и устранять слабые места во всём процессе производства данных. Предлагаемая «классификация причин бедности данных» включает покрытие интернетом, цифровую грамотность всего населения, доступный по цене трафик, кадры ИИ и стимулы инноваций, доступ к достаточно мощным чипам ИИ и супервычислениям, а также способность обучать местные модели на надёжных национальных или международных данных. Другой вопрос — должны ли международные меры, например налог на использование данных, перераспределять избыточную стоимость, когда транснациональные поставщики собирают значительные данные в странах с низким доходом.
Определение и отслеживание использованного объёма, расчёт избыточной стоимости и налоговых критериев и согласование инноваций с базовыми интересами бедного данными населения остаются сложными передовыми вопросами международного управления данными.
2. Управление в юрисдикциях предоставления услуг: утрата национального контроля
Трансграничные услуги генеративного ИИ должны подчиняться управлению обслуживаемых юрисдикций, но техническая непрозрачность создаёт трудности. Во-первых, доминирующие поставщики могут не раскрывать базовую информацию о прозрачности независимым академическим организациям или сопротивляться их оценке (Bommasani, 2023). Во-вторых, защита интеллектуальной собственности в странах происхождения поставщиков, главным образом США в данном изложении, может ограничивать доступ стран-пользователей к базовым технологиям, осложняя проверку систем и приложений (Lin, 2023).
В-третьих, несмотря на призывы приостановить разработки и согласовать их с государственным управлением, движимые капиталом итерации идут значительно быстрее подготовки правил, ставя органы власти в существенно более слабое техническое положение при решении правовых и этических вопросов.
Статья описывает несколько уровней институционального отсутствия или запаздывания. Во-первых, по её данным, к июлю 2023 года рамки защиты персональных данных имелись в 137 странах, то есть почти треть не имела базовых законов о приватности (ЮНКТАД, 2023). Во-вторых, до Руководства национальные стратегии ИИ были примерно у 67 стран; Руанда и Доминиканская Республика объявили свои позже. В-третьих, статья указывает, что к июлю 2023 года лишь около 40 стран имели политику этики ИИ. В-четвёртых, автор выделяет Китай, США и ЕС как юрисдикции, тогда рассмотревшие интеллектуальную защиту синтетических произведений и сформулировавшие ясные управленческие позиции. Китай опубликовал Временные меры по управлению услугами генеративного искусственного интеллекта до Руководства.
США выпустили исполнительный указ о безопасном и надёжном ИИ в конце октября 2023 года (The White House, 2023). 9 декабря 2023 года переговорщики Европарламента и Совета достигли предварительного политического соглашения по Акту об ИИ. Формальный закон относится к 2024 году; исходное упоминание «принятия» в декабре 2023 года нельзя понимать как окончательное принятие и вступление в силу тогда, как поясняют редакционные примечания.
3. Авторские права на данные предобучения: использование контента без разрешения
Сбор и использование обучающих наборов данных вызывают серьёзные споры о разрешении использовать данные людей и организаций и материалы, охраняемые авторским правом.
Модели обучаются на собранных в интернете текстах, звуках, коде, изображениях и иных материалах. Статья утверждает, что ведущие модели часто собирали их без предварительного разрешения, вызывая споры и судебные дела об интеллектуальной собственности, включая обвинения по законам о защите данных, таким как GDPR (Европейский союз, 2016). Подчёркивается пример новостной отрасли: в конце октября 2023 года американская News/Media Alliance, представлявшая более 2200 новостных издателей, заявила, что ChatGPT использовал миллионы платных статей и репортажей для обучения без разрешения правообладателей, и пыталась юридическими средствами добиться удаления из Common Crawl предположительно незаконно собранных материалов (Robertson, 2023).
Эти практики также затрагивают право на удаление данных, позволяющее их владельцам требовать удаления сведений, собранных без разрешения. Когда персональные данные уже повлияли на обученную модель, автор видит значительную трудность в устранении этого влияния. Оригинал использует абсолютные выражения вроде «нет возможности разучивания» и «невозможно»; здесь они ограничены рамками тогдашней аргументации. Цитируемое исследование рассматривает машинное разучивание, редактирование моделей и другие подходы, как объясняют редакционные примечания. Проблема включает устранение усвоенных ответов, отражающих взгляды и языковые или культурные особенности владельца данных (Zhang, 2023).
4. Объяснимость архитектуры: результаты непрозрачных моделей
Статья описывает архитектуры нейронных сетей как чёрные ящики, где трудно объяснить конфигурации узлов и слоёв, определения параметров и вычисления. Недавние достижения усиливают опасения. Даже если общий подход, включая алгоритмы, отчасти объясним, трудно объяснить отдельные параметры и их относительный вклад в результат. Большие фундаментальные модели используют обширные наборы параметров и весов для распознавания закономерностей и формирования ответов, что затрудняет объяснение, почему конкретная модель выдаёт определённый ответ. Автор ожидает, что рост масштаба и архитектурной сложности усугубит проблему.
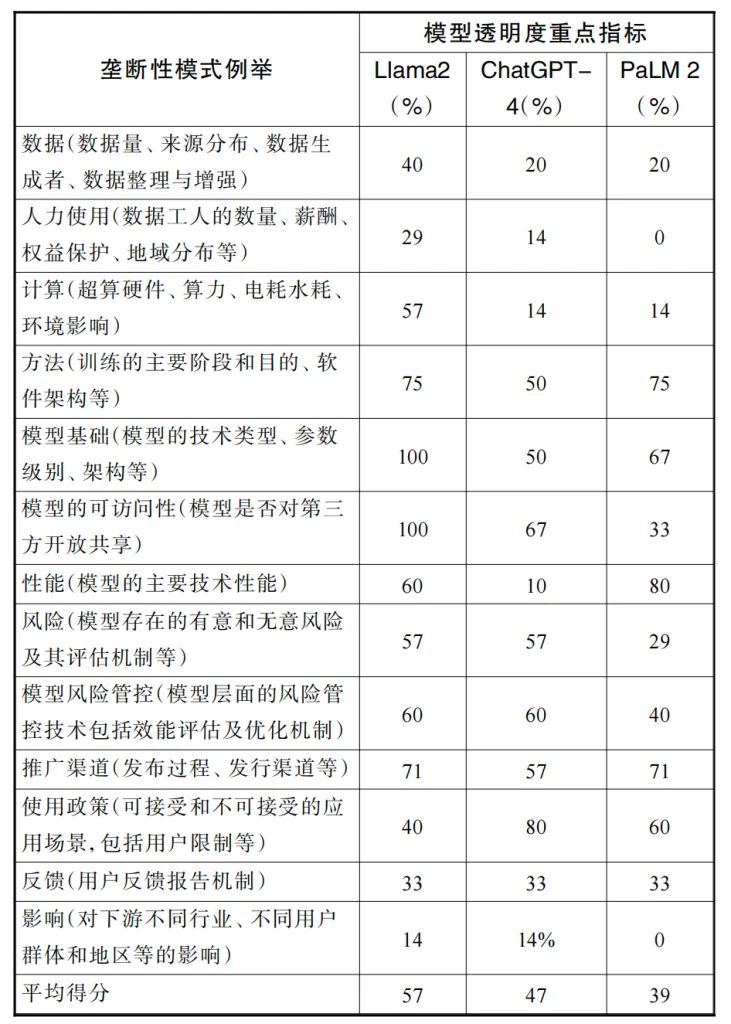
Технические пределы объяснимости взаимодействуют с нежеланием поставщиков раскрывать соответствующие сведения, затрудняя работу регуляторов и независимых исследователей по оценке намеренных рисков и непреднамеренного вреда. Стэнфордский индекс прозрачности фундаментальных моделей (Bommasani, 2023) оценивает важные технические элементы ведущих моделей. Статья ссылается на сравнение примерно десяти крупных моделей и воспроизводит в таблице 1 выбранные показатели трёх известных примеров. Её довод: непрозрачные модели и трудно выявляемые риски осложняют прослеживание ошибок и ограничивают прозрачную оценку и предупреждение. Приводятся рекомендации экспертов не использовать генеративный ИИ для задач высокого риска.
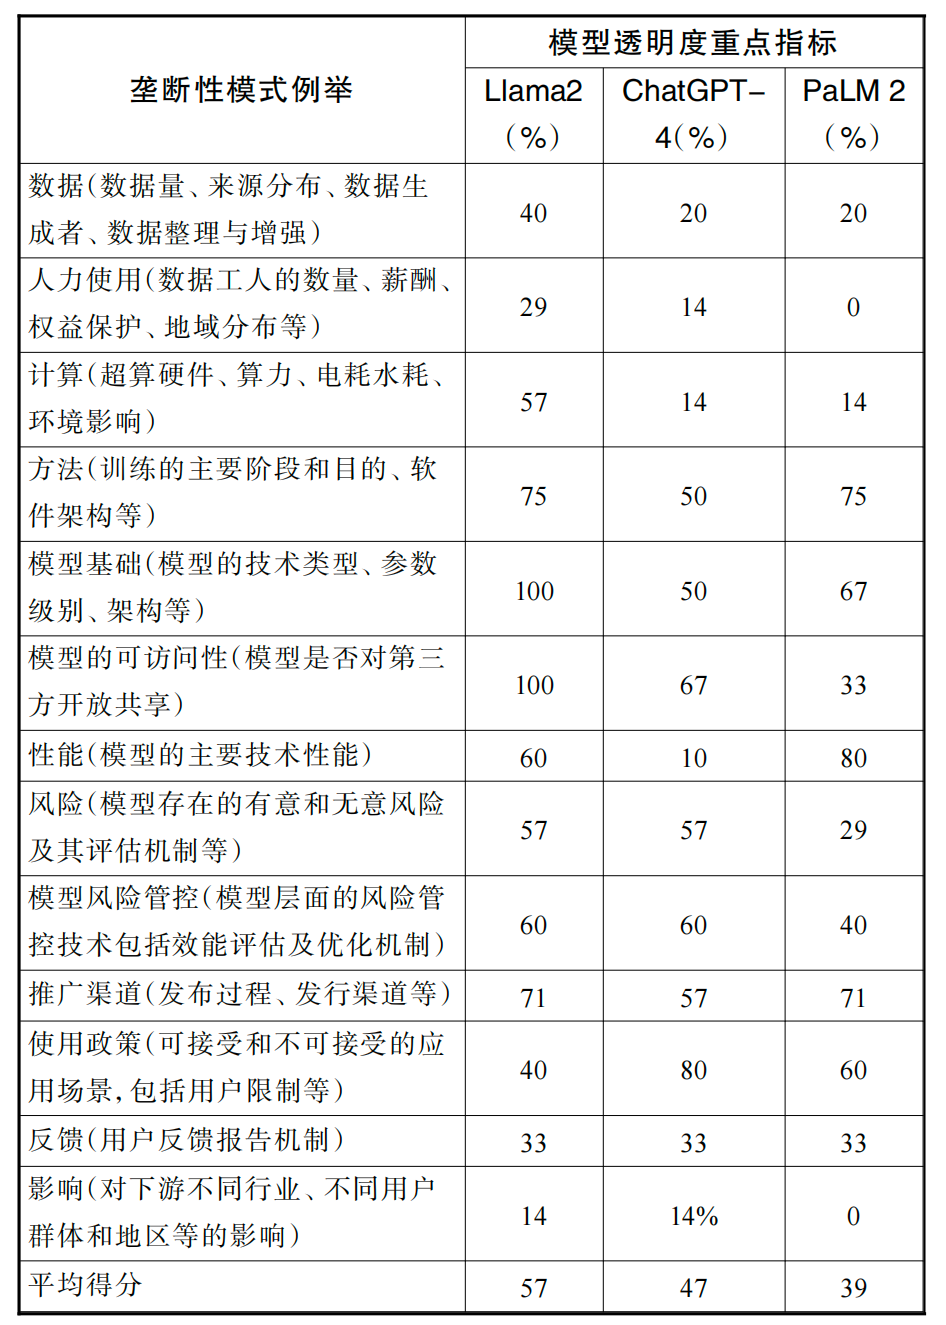
| Показатель | Llama 2 | ChatGPT-4 (обозначение журнала) | PaLM 2 |
|---|---|---|---|
| Данные: объём, распределение источников, создатели, отбор и обогащение | 40 | 20 | 20 |
| Труд: число работников данных, оплата, права и географическое распределение | 29 | 14 | 0 |
| Вычисления: оборудование, мощность, электричество, вода и экологические последствия | 57 | 14 | 14 |
| Методы: основные этапы обучения, цели и архитектура ПО | 75 | 50 | 75 |
| Основы модели: технологии, масштаб параметров и архитектура | 100 | 50 | 67 |
| Доступ к модели: доступность и предоставление третьим сторонам | 100 | 67 | 33 |
| Производительность: основные технические возможности | 60 | 10 | 80 |
| Риски: намеренные и ненамеренные риски и механизмы оценки | 57 | 57 | 29 |
| Снижение рисков модели: оценка и оптимизация | 60 | 60 | 40 |
| Распространение: процесс выпуска и каналы | 71 | 57 | 71 |
| Правила использования: разрешённые и запрещённые применения и ограничения пользователей | 40 | 80 | 60 |
| Обратная связь: механизмы сообщений пользователей | 33 | 33 | 33 |
| Воздействие: последующие отрасли, группы и регионы | 14 | 14 | 0 |
| Средняя оценка, напечатанная в оригинале | 57 | 47 | 39 |
5. Понимание: семантика и реальный мир
Генеративный ИИ вероятностно распознаёт контекстные закономерности и создаёт текст по усвоенному синтаксису. Автор связывает ограниченное семантическое понимание с галлюцинациями, содержащими фактические, исторические и научные ошибки. Исторический рейтинг Vectara на GitHub, последний раз обновлённый 1 ноября 2023 года, сообщал о частоте галлюцинаций в конкретной задаче 3–3,5 % у моделей GPT, 5,1–5,9 % у Llama и 12,1 % у Google PaLM. Эти значения относились к верности пересказа документов, а не к точности ответов на общие вопросы. Статья дополнительно предполагает более высокую частоту ошибок на китайском и других языках, но рейтинг не подтверждает такое межъязыковое сравнение. Поэтому учащиеся без прочных базовых знаний могут усваивать сомнительный контент в самостоятельных беседах.
Автор считает, что такие системы не следует рассматривать как надёжные источники учебного содержания. Он также отличает обработку синтаксических закономерностей от понимания объектов и отношений реального мира, человеческих и социальных отношений и отношений людей с объектами и технологиями. Научное открытие, отмечает он, требует наблюдения мира, эксперимента и рассуждения, тогда как генеративный ИИ в основном синтезирует прежнюю литературу. В его изложении новое знание требует человеческой субъектности при вспомогательной роли ИИ. Оригинал также делает вывод о «знании» из обсуждений авторского права; нельзя смешивать правовую охрану и определение знания. Опираясь на Candelon (2023), статья ставит под вопрос способность моделей предлагать адресные инновационные решения сложных реальных задач или выносить социальные ценностные суждения.
Она заключает, что модели не должны самостоятельно направлять освоение сложных знаний или решение слабоструктурированных проблем без учителей-людей.
Эти ограничения, по мнению автора, сдерживают положительное образовательное преобразование базового содержания, мышления высокого порядка, решения сложных проблем, ценностей и человеческого развития. Генеративный ИИ может влиять отчасти через внешнее оспаривание результатов обучения и оценивания: автоматизированная обработка контента и труднее выявляемая передача работы на сторону ослабляют ценность простого синтеза и производства как центральных результатов. Сокращение доли базовых упражнений по орфографии и синтаксису, обзоров литературы, изготовления слайдов и элементарных художественных работ в формирующем оценивании и оценках с невысокими последствиями может подтолкнуть системы пересмотреть учебные приоритеты и методы оценивания.
6. Загрязнение сгенерированной информацией: синтетический контент в интернете
Статья выделяет два вида загрязнения, возникающего из-за производства и распространения контента генеративного ИИ.
Во-первых, модели могут воспроизводить вредные материалы, усвоенные из интернета, включая дезинформацию, дискриминацию и язык ненависти, а затем вновь распространять их онлайн. Такой повторяющийся оборот может причинять учащимся разных возрастов вред, который трудно обратить.
Во-вторых, всё более насыщенный синтетическими материалами интернет влияет на обучение последующих моделей. Качественное глубокое обучение зависит от разнообразных человеческих данных и форм выражения, позволяющих усваивать разные закономерности. Когда машинный контент широко распространяется повторно, новые модели могут обучаться на выходах предыдущих. В описанном процессе высоковероятные события становятся избыточно представленными, а маловероятные — недостаточно представленными, постепенно стирая статистический длинный хвост. Он помогает сохранять точность и разнообразие. Его утрата может укреплять уже усвоенные закономерности и давать всё более однородные результаты, похожие на синтетические материалы, а не реальность, увеличивать ошибки и потенциально вызывать коллапс моделей.
Это создаёт дополнительные трудности получения качественных обучающих данных из интернета (Lutkevich, 2023).
7. Проецирование ценностей: унификация и языковое и культурное подавление
Проецирование сходных ценностей в сгенерированных ответах может подавлять группы в цифрово неблагоприятном положении, плюрализм образовательного построения знаний и выражение разных точек зрения.
Если строка часто встречается в обучающих данных, трансформер с большей вероятностью воспроизведёт её и связанные предложения. По статье распространённые убеждения и взгляды доминирующих СМИ в американских и европейских наборах могут стать «стандартными ответами» модели, по обратной связи укрепляя уже влиятельные ценности и языковые или культурные нормы. Некритическое внедрение без изучения происхождения данных способно усиливать культурные стереотипы. Цитируется Omiye (2023), чьи повторные испытания ChatGPT/GPT-3.5, GPT-4, Bard и Claude от Anthropic обнаружили предвзятые ответы с расовыми стереотипами в вопросах о лёгочной ёмкости, расчётной скорости клубочковой фильтрации, толщине кожи и размере мозга. Это примеры вредной предвзятости моделей, а не подтверждённые биологические утверждения.
Напротив, бедные данными и маргинализированные группы оставляют меньше следов в сети и слабо представлены в обучающих наборах, поэтому их ценности и языковые и культурные практики плохо распознаются. Автор считает локально значимые модели, поддерживающие разнообразие, важными для языков и культур коренных народов и законных интересов неблагополучных групп (Miao, 2023).
Чрезмерная опора на генеративный ИИ ради «стандартных ответов» и решений также может сужать идеи и ослаблять разнообразные инновации. В цитируемом исследовании Boston Consulting Group с более чем 750 участниками идеи, созданные с GPT-4, были, по данным исследования, на 41 % менее разнообразными, чем без него. Участники нередко слабо стремились увеличивать разнообразие после получения предложений модели. В том же исследовании 70 % выразили опасение, что длительное использование генеративного ИИ для ответов может разрушать человеческую креативность (Candelon, 2023). Эти результаты относятся к условиям данного исследования.
8. Незаконные дипфейки: упрощение создания и распространения
Генеративный ИИ снижает требования к навыкам и затратам для производства незаконных дипфейков, одновременно затрудняя обнаружение и облегчая создание и распространение.
Статья рассматривает, как люди без навыков журналистики, музыки или видеопроизводства могут использовать синтетический контент для выдачи себя за реальных людей, распространения ложных новостей или ненависти, клеветы, изменения существующих изображений и видео либо иных незаконных целей. Автор противопоставляет неясную пользу решения общественно значимых проблем доступности инструментов для злоупотреблений. Цитируемый отчёт State of Deepfakes за 2023 год (Home Security Heroes, ныне Security Hero) утверждал, что откровенный сексуальный дипфейк длительностью шестьдесят секунд можно бесплатно создать по одному чёткому снимку лица менее чем за двадцать пять минут. Отчёт анализировал 95 820 видео и описывал рост на 550 % относительно 2019 года; исходные «почти миллион новых видео» и «в 5,5 раза» исправлены по этому источнику.
Цифры относятся к обследованию отчёта, а не к проверенной всемирной переписи или текущему итогу. По отчёту 98 % обследованных дипфейков были порнографическими, а 99 % людей, на которых они были направлены в этой категории, составляли женщины.
III. Рекомендации по регулированию
Для преодоления этих противоречий и развития образовательного потенциала Руководство предлагает человекоцентричные принципы разработки и применения ИИ. Подход «приоритет регулирования, обеспечение инклюзии, направление практического применения» нацелен на этичное, безопасное, надёжное, справедливое, инклюзивное и осмысленное использование.
1. Человекоцентричный подход к управлению ИИ и его применению
С 2019 года ЮНЕСКО выступает за человекоцентричные исследования и применение ИИ, раскрывая этот подход в документах, включая Рекомендацию об этических аспектах искусственного интеллекта (цитируется как UNESCO, 2022), Пекинский консенсус по искусственному интеллекту и образованию (UNESCO, 2019) и ИИ и образование: руководство для разработчиков политики (цитируется как Miao, 2022). В данном изложении управление и использование должны защищать основные права, достоинство и культурное разнообразие наряду с биоцентрическим пониманием гармоничных отношений людей, среды и экосистем. Развитие должно служить людям и укреплять возможности эффективного сотрудничества человека и машины.
На всём протяжении проектирования, разработки, использования и итераций человеческая субъектность должна оставаться центральной вместе с надёжностью, соответствием людям и целям, объяснимостью, человеческим контролем и ответственностью (Miao, 2022).
2. Дорожная карта управления генеративным ИИ
Руководство рекомендует совместное управление с участием всего правительства, определяющее права, полномочия, ответственность и обязательства участников разных секторов и отраслей.
2.1 Согласовывать международные инструменты, включая правила трансграничной защиты данных
Взаимно признаваемые правила защиты данных и механизмы трансграничного управления предлагаются как необходимые условия устранения юрисдикционных пробелов. GDPR служит примером правовой основы управления трансграничными услугами данных.
2.2 Разрабатывать общеправительственные стратегии ИИ и межсекторальное этическое управление
Общеправительственная стратегия может координировать управление ИИ между секторами и ведомствами. Механизмы этического управления должны уточнять национальный суверенитет данных; права на данные и приватность организаций и людей; законные отношения производства данных; основные принципы разработки и использования ИИ; распределение избыточной стоимости продуктов ИИ, построенных на общедоступных или чужих данных.
2.3 Создавать правила специально для генеративного ИИ
Китай опубликовал Временные меры по управлению услугами генеративного искусственного интеллекта в июле 2023 года. Автор описывал их как первые в мире формальные правила юрисдикционного управления такими услугами — сравнительное суждение в историческом контексте оригинала. Он предлагал уточнять правовые и этические положения с помощью Руководства и тогдашних европейских и американских инициатив. Для образования особенно значимы следующие пункты:
1. Классифицировать технические риски безопасности и регулировать по уровню риска. В изложении обсуждавшегося тогда европейского проекта Акта об ИИ статья различает неприемлемые риски, включая технологии манипулирования несовершеннолетними для формирования зависимости, распознавание эмоций и некоторые предсказания интеллекта или поведения; высокие риски; ограниченные риски; минимальные риски. Описываются подходы от запретов разработки и вывода на рынок через интенсивный надзор, проверку и контроль до отраслевого саморегулирования. Образование выделялось как область пристального внимания. Это категории, обсуждаемые историческим текстом, а не изложение всех положений позднее принятого закона.
2. Установить возрастные гарантии для самостоятельного общения с генеративным ИИ. Поскольку диалоговые модели могут создавать неподходящие несовершеннолетним материалы, Руководство рекомендует тринадцать лет как нижнюю границу самостоятельного использования, одновременно рассматривая более строгий порог шестнадцати лет. По мере перехода от чатов на платформах к приложениям на личных устройствах регуляторам и взрослым может быть труднее контролировать самостоятельное использование. Автор призывает оценивать риски и уточнять ответственность за надзор за использованием несовершеннолетними. Последнее упоминание «взрослых» в исходном абзаце по контексту исправлено на «несовершеннолетних». Тринадцать и шестнадцать лет — обсуждаемые рекомендации, а не универсальный законный возраст общения с ИИ.
3. Уточнить обязанности других участников. Статья сопоставляет китайские Меры, ориентированные на поставщиков, с более широкими институциональными обязанностями в американском исполнительном указе 2023 года. Предлагаются обязанности организаций, закупающих и внедряющих системы ИИ: совместно проверять законность данных, инструментов и контентных услуг и помогать отслеживать меняющиеся последствия для пользователей, особенно неблагополучных групп. После уточнения институциональных обязанностей следует рассмотреть и обязанности отдельных пользователей, включая осведомлённость и навыки распознавания угроз и самозащиты, знания и умения законного использования инструментов и сгенерированных материалов.
4. Уточнить маркировку, авторское право и допустимое использование сгенерированного контента. Китайские Меры требуют от поставщиков маркировать сгенерированные изображения и видео согласно правилам интернет-информационных услуг глубокого синтеза. Оригинал также приписывает маркировку контента ИИ GDPR; законодательство о данных и о прозрачности ИИ необходимо различать, как объясняют редакционные примечания. Автор считает, что три рассматривавшиеся тогда системы правил не разрешали всех вопросов законного использования сгенерированных продуктов. Открытыми оставались ограничение незаконных дипфейков; определение и защита прав платящих пользователей на сгенерированные материалы; различение синтеза литературы с помощью ИИ в исследовании под руководством человека и обмана, нарушающего академическую этику или учебные правила.
IV. Политические и практические рекомендации для образования
Руководство даёт подробные рекомендации по эффективным образовательным применениям. Статья выделяет следующие:
1. Обеспечивать инклюзию, справедливость, языковое и культурное разнообразие
Связь генеративного ИИ с человекоцентричными принципами имеет четыре следствия. Во-первых, справедливый доступ и равные возможности — предпосылки образовательной инклюзии: возможности должны быть у людей независимо от пола, этнической принадлежности, способностей, социально-экономического положения или постоянного места жительства. Страны должны использовать предложенную классификацию причин бедности данных для выявления исключённых групп и устранения конкретных пробелов. Во-вторых, специальное финансирование должно поддерживать инструменты для обучающихся на протяжении жизни людей разных возрастов и способностей, включая людей с особыми образовательными потребностями.
В-третьих, оценка должна выявлять предвзятость источников данных, предварительной обработки, проектирования моделей и результатов, включая гендерные перекосы, стереотипы об отдельных группах, дискриминацию маргинализированных людей и язык ненависти. В-четвёртых, показатели языкового и культурного разнообразия должны поддерживать языки меньшинств и коренных народов в данных предобучения, архитектурах и методах обучения, предотвращая их исключение или введение предвзятой фильтрации и последующей обработки.
2. Защищать человеческую субъектность
По мере роста возможностей генеративного ИИ и частичной автоматизации элементарной обработки контента образовательное использование может ослаблять субъектность. Лёгкость создания сочинений или простых художественных работ способна усиливать зависимость от внешнего контента и сокращать возможности тренировать мышление и развивать базовые знания и навыки. Поэтому защита и усиление субъектности должны быть центральными при проектировании и внедрении: ИИ может бросать вызов человеческому мышлению и расширять его, но не должен его присваивать. Руководство предлагает семь гарантий. Во-первых, объяснять, какие данные учащихся собираются, как используются и как могут повлиять на образовательную и общественную жизнь. Во-вторых, защищать внутреннюю мотивацию и человеческую автономию решений и действий в преподавании и обучении с ИИ.
В-третьих, сохранять возможности развития познания и социальных навыков через наблюдение реальности, эмпирические методы, включая эксперименты и обсуждения, и логическое рассуждение. В-четвёртых, обеспечивать социальное взаимодействие и работу с произведениями людей, предотвращая чрезмерную зависимость или привыкание. В-пятых, советоваться с исследователями, учителями и учащимися до масштабного внедрения. В-шестых, поощрять вопросы о технических методах, точности, встроенных ценностях и педагогических последствиях. В-седьмых, учителя и учащиеся должны сохранять ответственность за решения, принятые с помощью ИИ.
3. Проверять и контролировать образовательные инструменты ИИ и развивать локально подходящие фундаментальные модели
Этика на этапе проектирования и подход жизненного цикла должны направлять разработку и внедрение, защищая учащихся, учителей и образовательные отношения от предсказуемых технических или этических рисков и неподходящих инструментов. Для существующих систем Руководство рекомендует проверку, допуск и постоянный мониторинг. Этическая проверка должна оценивать уменьшение предвзятости, особенно гендерной, и языковую и культурную репрезентативность данных. До допуска системы должны избегать предсказуемого вреда, показывать образовательную ценность, соответствовать возрасту и возможностям учащихся и институциональным принципам о знаниях, навыках, ожидаемых результатах и ценностях.
Использование данных и разрешение услуг требуют понятной информации о рисках, применимых мер опеки, соответствующего возрасту информирования, доступности и действительного согласия. Инвалидность сама по себе не определяет правоспособность; редакционные примечания объясняют исправление широкого обобщения оригинала по статье 12 Конвенции о правах инвалидов. Проверки должны также выявлять дипфейки, ложные новости, язык ненависти и другие вредные или незаконные результаты и оценивать экологические затраты, включая электричество и воду для обучения моделей, в местном контексте.
Статья видит недостатки культурной и языковой пригодности тогдашних ведущих моделей за пределами США и Европы. При уважении законной международной конкуренции она рекомендует активное развитие для улучшения местной пригодности: поддерживать безопасные, контролируемые национальные фундаментальные модели с надлежащими правовыми условиями; создавать и итеративно испытывать образовательные генеративные предобученные трансформеры, или модели EdGPT, на основе местных ценностей, языкового и культурного разнообразия и учебных стандартов; стимулировать платформы и расширения, поддерживающие исследовательское обучение и разные учебные выборы. Цель — экосистема совместного развития фундаментальных моделей и последующих образовательных приложений вокруг местных языков, культур и программ.
4. Развивать компетенции учителей и учащихся в области ИИ
Компетенции ИИ, особенно у школьников, необходимы для безопасного, этичного и осмысленного применения. По статье к середине 2022 года только около пятнадцати стран имели школьные программы ИИ, одобренные на национальном уровне (UNESCO, 2022), что усиливало срочность базовой грамотности в ИИ для всех. Разрабатывавшаяся тогда структура для учащихся организовывала компетенции по измерениям и уровням, объединяя занятия в классе и вне его. Измерения включали человекоцентричное понимание ИИ, этику ИИ, базовые технологии и применения, проектирование систем ИИ. Уровни понимания, применения и создания описывали знания, навыки и установки. Таблица 2 сохраняет этот исторический проект.
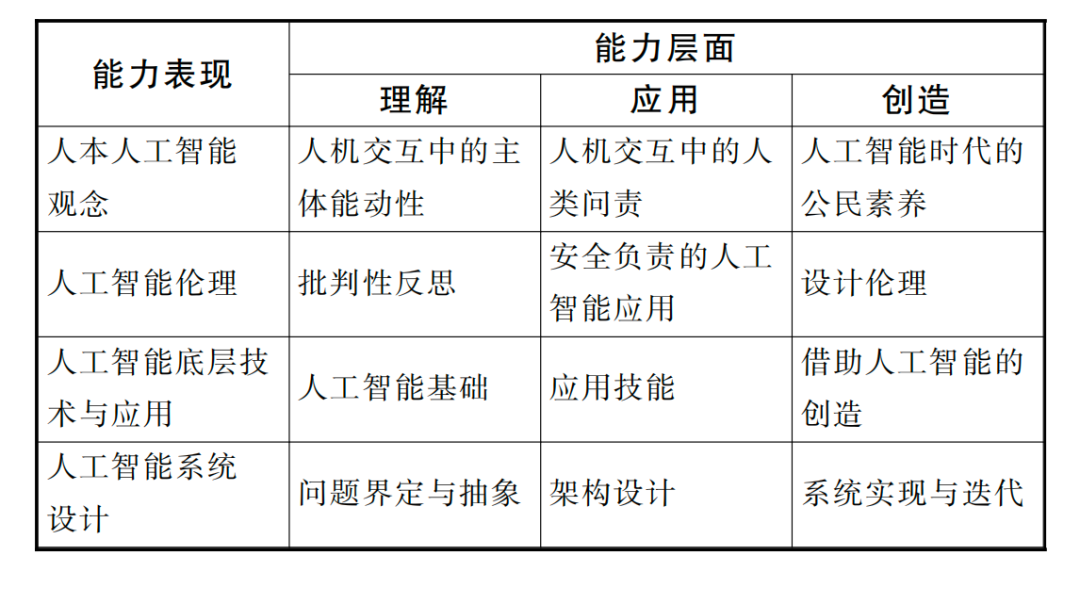
| Измерение компетенции | Понимание | Применение | Создание |
|---|---|---|---|
| Человекоцентричное понимание ИИ | Субъектность во взаимодействии человека и ИИ | Ответственность человека во взаимодействии с ИИ | Гражданственность в эпоху ИИ |
| Этика ИИ | Критическая рефлексия | Безопасное и ответственное применение ИИ | Этика на этапе проектирования |
| Основы и приложения ИИ | Основы ИИ | Навыки применения | Создание с помощью ИИ |
| Проектирование систем ИИ | Определение и абстрагирование задачи | Проектирование архитектуры | Реализация и итерации |
ЮНЕСКО также разрабатывала структуру для учителей, призванную направлять национальные стандарты и подготовку для надлежащего применения; в таблице 3 она представлена как исходный исторический проект. Пять измерений включали человекоцентричное понимание ИИ, этику ИИ, основы и приложения, интеграцию ИИ с педагогикой и профессиональное развитие с помощью ИИ. Три уровня — освоение, углубление и создание — описывали результаты для учителей с разными стартовыми возможностями. Освоение предназначалось всем учителям после подготовки, включая не имевших прежней подготовки в ИИ и работавших в условиях дефицита ресурсов. Углубление ориентировалось на учителей со средними знаниями и опытом. Создание предполагало экспертный уровень у учителей с обширными знаниями ИИ и значительным опытом применения.
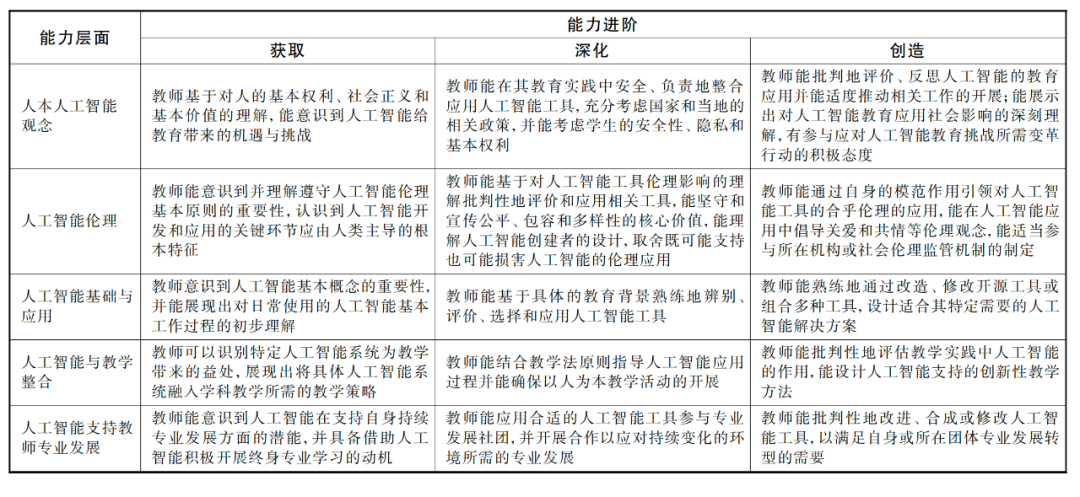
| Измерение компетенции | Освоение | Углубление | Создание |
|---|---|---|---|
| Человекоцентричное понимание ИИ | Осознавать образовательные возможности и вызовы ИИ на основе понимания основных прав, социальной справедливости и базовых ценностей. | Безопасно и ответственно интегрировать инструменты ИИ в образовательную практику с учётом национальной и местной политики, безопасности, приватности и основных прав учащихся. | Критически оценивать и осмыслять образовательный ИИ, надлежащим образом продвигать связанную работу, понимать социальные последствия и позитивно участвовать в необходимых для решения проблем изменениях. |
| Этика ИИ | Понимать важность этических принципов и распознавать человекоцентричные аспекты на всём протяжении разработки и применения. | Критически оценивать и адаптировать инструменты по их этическим последствиям; поддерживать справедливость, инклюзию и разнообразие и понимать, как проектные решения и компромиссы разработчиков могут поддерживать либо подрывать этичное применение. | Показывать пример этичного применения, продвигать и распространять этические идеи и участвовать в создании институционального или общественного надзора за этикой ИИ. |
| Основы и приложения ИИ | Распознавать важные базовые понятия и показывать начальное понимание работы повседневных инструментов ИИ. | Умело определять, оценивать, выбирать и применять инструменты в конкретных образовательных условиях. | Выбирать или разрабатывать и адаптировать открытые инструменты либо сочетать инструменты для проектирования решений ИИ под конкретные потребности. |
| Интеграция ИИ и педагогики | Определять учебные преимущества системы и демонстрировать стратегии её интеграции в преподавание предмета. | Направлять применение ИИ педагогическими принципами и обеспечивать человекоцентричные учебные занятия. | Критически оценивать роль ИИ в преподавательской практике и проектировать инновационные педагогические методы с поддержкой ИИ. |
| Профессиональное развитие с помощью ИИ | Осознавать потенциал ИИ для непрерывного профессионального развития и сохранять мотивацию профессионального обучения на протяжении жизни с его помощью. | Использовать подходящие инструменты для участия в профессиональных сообществах и совместного развития в меняющихся условиях. | Критически адаптировать, сочетать или изменять инструменты для личных или общественных потребностей профессионального развития. |
5. Поощрять творческое преподавание, плюрализм построения знаний и разнообразие выражения
Образование поддерживает цивилизацию и её дальнейшее развитие через языковое и культурное разнообразие, индивидуальное осмысление и разные формы выражения. Автор считает, что воспроизведение мировоззрения владельцев обучающих данных может подавлять альтернативные взгляды и угрожать этой миссии. Поэтому генеративный ИИ не следует считать авторитетным источником знаний ни по одному предмету. Учителя и учащиеся должны критически оценивать результаты, признавая пользу быстрого поиска информации, литературы и преобразования форматов, но ожидая ненадёжного содержания. Преподавание должно соответствовать учащимся, побуждая их оценивать транслируемые ценности и культурные предпосылки и применять синтез литературы и обработку данных для исследования.
Учащимся также нужны достаточные возможности проб и ошибок без ИИ, эмпирических экспериментов и наблюдения реального мира.
6. Изучать долгосрочные образовательные последствия между дисциплинами и секторами
Хотя исследование прослеживает известные процессы и ограничения, быстро развивающиеся фундаментальные модели и последующие приложения взаимодействуют с крайне разнообразными и неопределёнными образовательными ситуациями. Их образовательное значение нельзя оценивать узко по существующим недостаткам или исключительно скептически. Руководство призывает к сотрудничеству исследователей и поставщиков ИИ, теоретиков образования, исследователей когнитивных нейронаук и других направлений, учителей, учащихся и родителей. Вместе они должны изучать долгосрочные последствия для производства и освоения знаний, авторского права и исследований, программ и оценивания, человеческого сотрудничества и социального развития, затем осторожно пересматривать учебные рамки, образовательные цели и экзамены и вносить надлежащие системные изменения.
Оценка образовательного потенциала крупного технического достижения в обработке контента не должна начинаться и завершаться коммерческими заявлениями или ростом производительности создания контента. Отправной точкой остаются человекоцентричные принципы. Педагоги должны исследовать противоречия на всём жизненном цикле ИИ и учитывать последствия для справедливости, инклюзии, ценностей, языкового и культурного разнообразия. По заключению автора, это необходимо, чтобы люди и сообщества как участники и благополучатели образования не стали подопытными или слугами ИИ, движимого коммерческими интересами.
Литература
- Bishop, J. M.(2021). Artificial Intelligence is stupid and causal reasoning won't fix it[J]. Frontier in Psychology, 2021(11):1-18.
- Bommasani, R., Hudson, D. A., Adeli, E., et al (2021). On the opportunities and risks of foundation models[DB/OL]. [2023-10-16]. https://crfm.stanford.edu/report.html.
- Bommasani, R., Klyman, K., Longpre, S. et al.(2023). The foundation model transparency index.[DB/OL]. [2023-10-10]. https://arxiv.org/abs/2310.12941.
- Candelon, F., Krayer, L., Rajendran,S. et al.(2023). How people can create and destroy value with generative AI[DB/OL]. [2023.10-12]. https://www.bcg.com/publications/2023/how-people-create-and-destroy-value-with-gen-ai.
- European Parliament(2023). MEPs ready to negotiate first-ever rules for safe and transparent Al. [DB/OL. [2023-10-18]. https://digital-strategy.ec.europa.eu/en/policies/european-approach-artificial-intelligence.
- European Union(2016). General Data Protection Regulation[DB/OL].[2023-08-09]. http://data.europa.eu/eli/reg/2016/679/oj.
- GitHub(2023). Hallucination Leaderboard. [DB/OL]. [2023-11-08]. https://github.com/vectara/hallucination-leaderboard.
- Home Security Hero(2023). State of deepfakes: Realities,threats, and impact [DB/OL].[2023-11-11]. https://www.homesecurity-heroes.com/state-of-deepfakes/#key-findings.
- Lin, B.(2023). Al is generating security risks faster than companies can keep pp.[DB/OL].[2023-08-25]. https://www.wsj.com/articles/ai-is-generating-security-risks-faster-thancompanies-can-keep-up-a2bdedd4.
- Lutkevich, B.(2023). Model collapse explained: How synthetic training data breaks AI [DB/OL].[2023-10-28]. https://www.techtarget.com/whatis/feature/Model-collapse-explained-How-synthetic-training-data-breaks-AI.
- Marwala, T(2023). Algorithm Bias: Synthetic Data Should Be Option of Last Resort When Training Al Systems.[DB/OL]. [2023-07-31].https://unu.edu/article/algorithm-bias-synthetic-data-should-be-option-last-resort-when-training-ai-systems.
- Miao, F.(2022). Al and education: Guidance for policymakers|M]. Paris, UNESCO.
- Miao, F.et al(2023). Guidance on generative Al in education and research [M]. Paris: UNESCO 2023.
- 苗逢春(2022). 教育人工智能伦理的解析与治理: 人工智能伦理问题建议书的教育解读[J].中国电化教育,2022(6):22-36.
- 苗逢春(2023). 数字文明变局中的教育数字化转型[J].电化教育研究,(2):47-63,91.
- Omiye, J. A., Lester, J.C., Spichak, S. et al.(2023). Large language models propagate race-based medicine[J]. Digital Medicine, 2023(6):195:1-4.
- Pearl, J.,& Mackenzie, D.(2018). The book of why: The new science of cause and effect [M]. NY: Basic Books.
- Robertson, K.(2023). News group says A. I. Chatbots heavily rely on news content [EB/OL]. The New York Times. https://www.nytimes.com/2023/10/31/business/media/news-artificial-intelligence-chatbots.html.
- Stanford University(2019). The 2019 Al Index Report[DB/OL].[2023-1018]. https://hai.stanford.edu/ai-index-2019.
- The White House(2023). Executive order on the safe, secure, and trustworthy development and use of artificial intelligence [OL] The White House. https://www.whitehouse.gov/briefing-room/presidential-actions/2023/10/30/executive-order-on-the-safe-secure-and-trustworthy-development-and-use-of-artificial-intelligence/.
- Thompson, A. D.(2023). Contents of GPT-3 & the pile v1[EB/OL].[2023-1018]. https://lifearchitect.ai/models/#gpt-3-top-10.
- Touvron H, Martin, L, Stone, K et al.(2023) Llama 2: Open foundation and fine-tuned chat models[DB/OL][2023-10-16]. https://ai.meta.com/research/publications/llama-2-open-foundation-and-fine-tuned-chat-models.
- UNCTAD(2023). Data protection and privacy legislation worldwide [DB/OL].[2023-07-18]. https://unctad.org/page/data-protection-and-privacy-legislation-worldwide.
- UNESCO(2019). Beijing consensus on artificial intelligence and education[S].Paris, UNESCO.
- UNESCO(2022). Recommendation on the Ethics of Artificial Intelligence[S]. Paris, UNESCO.
- Zhang, D., Finckenberg-Broman, P., Hoang, T., et al(2023). Right to be forgotten in the era of large language models: Implications, challenges, and solutions [DB/OL]. arXiv: 2307.03941v3 [cs.CY]22 Sep 2023.
- 中共中央、国务院(2022). 关于构建数据基础制度更好发挥数据要素作用的意见 [EB/OL].[2023-10-23]. https://www.gov.cn/zhengce/2022-12/19/content_5732695.htm.
Исходные англоязычные сведения журнала — архив
Generative AI and its Uses in Education: Foundational Controversies and Responding Strategies
MIAO Fengchun 1,2
1. National Engineering Laboratory for Cyberlearning and Intelligent Technology, Faculty of Education, Beijing Normal University,
2. Headquarters of UNESCO
Abstract: The paper is the second edition of a serials of interpretative articles on the Guidance on generative AI in education and research released by UNESCO, and the main aim of this edition is to examine the controversies around generative AI and its use in education. Based on an analysis of how it works, the development and deployment of generative AI have triggered the following controversies: worsening digital poverties, outpacing domestic governance, the collection of pre-training data without consent, the unexplainability of the architecture, the foundational models can't under the real world, the outputs of generative AI is polluting the internet, the outputs are projecting dominant values, amplifying the creation and dissemination of illegal deepfakes. Generative AI poses direct and most profound threats on the core values of education including inclusion, equity, cultural and linguistic diversities, pluralism in knowledge construction and expression, and therefore, those core values should be upheld as the logic base when examining the proportionality of generative AI to service purposes of education. Policy-makers and practitioners should follow the logic roadmap of "prioritizing regulation, ensuring inclusion, and guiding applications" to enhance the system-wide governance regulations in order to ensure trustable, self-automatic, and locally relevant eco-systems of generative AI for education, followed by developing capacities and guidance to steer proper uses of generative AI in education.
Keywords: generative AI;content processing across symbolic representations of human thinking;sources of pre-training datasets;equity, inclusion, cultural and linguistic diversities
Редакционные примечания и источники проверки
- Даты публикации: журнал указывает февраль 2024 года, том 30, № 1, страницы 4–15, DOI 10.13966/j.cnki.kfjyyj.2024.01.001. Исходная дата архива сайта — 27 января 2024 года — сохраняется отдельно. Оригинальная статья; DOI; Номер журнала
- Технические названия: ChatGPT, выпущенный 30 ноября 2022 года, первоначально использовал серию GPT-3.5. Токен не обязательно равен байту. Стэнфорд разработал Alpaca дообучением LLaMA 7B от Meta; оригинал ошибочно приписывал Alpaca компании Meta. Эти обозначения исправлены. Запуск ChatGPT; Стэнфордская Alpaca
- Масштаб моделей и обучающие данные: исходное утверждение о «1,8 триллиона» параметров GPT-4 не подтверждалось официальным техническим отчётом, который не раскрывал размер модели. Оценки корпуса GPT-3, долей источников и языков и вычислений за 2012–2019 годы остаются историческими сведениями с указанием источников, а не описаниями первоначального ChatGPT или последующих моделей. Технический отчёт GPT-4
- Историческое регулирование: 9 декабря 2023 года было достигнуто предварительное политическое соглашение ЕС; формальный Акт об ИИ — законодательство 2024 года. Полное название китайского документа — Временные меры по управлению услугами генеративного искусственного интеллекта, объявленные 13 июля 2023 года и действующие с 15 августа. Предложения изменений и сравнения с американским указом остаются историческим анализом. Соглашение ЕС 2023 года; Акт ЕС об ИИ 2024 года; Оригинал CAC
- Возраст и маркировка: тринадцать и шестнадцать лет — обсуждаемые рекомендации, не универсальный законный возраст общения с ИИ. Статья 8 GDPR касается согласия детей на обработку данных при определённых условиях. Последнее «взрослые» в исходном абзаце исправлено на «несовершеннолетние». Требования маркировки или прозрачности статьи 12 китайских Мер и статьи 50 Акта ЕС об ИИ 2024 года следует отличать от правил защиты данных GDPR. GDPR; Оригинал CAC; Акт ЕС об ИИ 2024 года
- Разучивание: исходное утверждение о невозможности слишком категорично. Цитируемая версия Zhang и соавторов от 22 сентября 2023 года рассматривает дифференциальную приватность, машинное разучивание, редактирование моделей и проектирование запросов. Проблема удаления влияния данных сохраняется вместе с этими техническими путями и сложностями реализации. Цитируемое исследование 2023 года
- Частота галлюцинаций: проценты относятся к исторической задаче Vectara по верности пересказа документов. Версия от 1 ноября 2023 года использовала 831 документ, пересказанный всеми сравниваемыми моделями. Это не частота ошибок ответов на общие вопросы и не доказательство частоты ошибок на китайском. Дана ссылка на фиксированную историческую ревизию, а не на меняющийся текущий рейтинг. Исторический рейтинг Vectara
- Статистика дипфейков: цитируемый отраслевой отчёт анализировал 95 820 видео и описывал рост на 550 % с 2019 года. Исходное «почти миллион новых видео» противоречит источнику; «в 5,5 раза» нельзя приравнивать к процентному росту. Значения 98 % и 99 % сохраняют принадлежность обследованию отчёта и не выдаются за всемирную перепись или актуальные цифры. Отчёт о дипфейках 2023 года
- Инвалидность и разрешение: оригинал обобщённо относил несовершеннолетних и людей с инвалидностью к не имеющим полной «уголовной дееспособности», что не является действительным общим правилом разрешения. Это издание различает применимую опеку, соответствующую возрасту информацию, доступность, поддержку принятия решений и действительное согласие. Статья 12 Конвенции о правах инвалидов признаёт равную правоспособность и необходимые поддержку и гарантии её осуществления. Конвенция о правах инвалидов
- Структуры компетенций и исследовательские суждения: таблицы 2 и 3 сохраняют проекты, разрабатывавшиеся при написании статьи; последующие структуры 2024 года освещены отдельно. Утверждения о понимании, знаниях, авторском праве и творчестве — доводы автора того времени. Статистика и сравнительные результаты относятся к условиям исходных исследований. Оригинальная статья
Источник: Miao, Fengchun (2024), Generative AI and its Uses in Education: Foundational Controversies and Responding Strategies, Open Education Research, 30(1), 4–15. Организации автора и исходные англоязычные сведения сохранены по архиву. Соответствующие права остаются у журнала и авторов.
Связанные исследования и ресурсы
Читайте также: руководство ЮНЕСКО по генеративному ИИ; первая статья об образовательной пригодности; материал о структурах компетенций ИИ для учителей и учащихся 2024 года; ресурсы специального и инклюзивного образования.
Исходная ссылка: https://aiedchair.bnu.edu.cn/news-6398-ru/