Cet article de Fengchun Miao est paru dans Open Education Research, volume 30, numéro 1 de 2024, comme deuxième interprétation du Guide pour l’IA générative dans l’éducation et la recherche de l’UNESCO. Cette édition respecte l’intégralité du périmètre du texte original, avec trois figures, vingt-sept références et les métadonnées originales en anglais, tout en proposant des sections structurées et des tableaux textuels accessibles. Les jugements techniques, statistiques et analyses de politiques doivent être lus dans le contexte de rédaction de 2023 ; les corrections de noms, de chiffres et de descriptions juridiques sont documentées dans les notes éditoriales.
Fengchun Miao — affiliations 1 et 2
1. Centre national de recherche en ingénierie du cyberapprentissage et des technologies intelligentes, Université normale de Beijing.
2. Siège de l’UNESCO.
Résumé : Cet article est le deuxième d’une série consacrée à l’interprétation du Guide pour l’IA générative dans l’éducation et la recherche de l’UNESCO. Il examine les controverses fondamentales liées à l’IA générative et à ses applications éducatives. L’analyse des limites techniques à chaque étape de son fonctionnement met en évidence l’aggravation de la pauvreté en données, l’opacité technologique et les lacunes de la gouvernance nationale, la collecte non autorisée de données d’entraînement, la difficulté à expliquer les architectures des modèles, la compréhension du monde réel par les modèles de fondation, la pollution d’internet par les contenus générés, la projection des valeurs dominantes et la diffusion d’hypertrucages illicites.
Selon l’article, l’IA générative peut profondément affecter des valeurs éducatives telles que l’égalité, l’inclusion, la capacité d’action des apprenants, la diversité des valeurs, des langues et des cultures, ainsi que le pluralisme dans la construction des connaissances. Ces valeurs devraient constituer le point de départ de l’évaluation de sa pertinence éducative. Les responsables publics et les praticiens devraient suivre une démarche consistant à « donner la priorité à la réglementation, garantir l’inclusion et orienter les applications », en renforçant la réglementation et son application à l’échelle du système afin de créer des écosystèmes éducatifs d’IA générative sûrs, dignes de confiance, maîtrisables de manière autonome et adaptés au contexte local.
Le développement des capacités et l’accompagnement pratique devraient ensuite soutenir des usages éducatifs appropriés.
Mots-clés : intelligence artificielle générative ; traitement des contenus ; provenance des jeux de données d’entraînement ; équité, inclusion et diversité linguistique et culturelle.
Introduction
En novembre 2022, OpenAI a lancé ChatGPT, ouvrant une nouvelle phase du passage de l’IA générative de la recherche aux usages commerciaux et publics. La version initiale de ChatGPT reposait sur la série GPT-3.5 ; l’appellation « ChatGPT-3 » de l’article original est corrigée ici à partir des informations de lancement du développeur, comme l’expliquent les notes éditoriales. L’article répartit en quatre domaines les effets et les réactions réglementaires observés pendant environ la première année suivant ce lancement.
1. Monopole et diversité. L’article décrit OpenAI, Google et Meta comme établissant des positions de domination verticale allant des modèles de fondation à l’infrastructure de réseau et au traitement du texte, des images, du son et de la vidéo. D’autres grandes entreprises et les communautés de modèles ouverts recherchaient des modèles de fondation ouverts, un choix plus large de plateformes et une plus grande diversité linguistique et culturelle, par la concurrence dans la recherche et le développement des écosystèmes.
2. Application et substitution. L’IA générative se diffusait rapidement dans les activités commerciales et accélérait l’automatisation des emplois dans les secteurs concernés.
3. Controverse et gouvernance. Les préoccupations de sécurité et d’éthique passaient de craintes théoriques à des affaires judiciaires concrètes. La confiance dans le potentiel de transformation coexistait avec les inquiétudes quant aux conséquences humaines, accélérant des initiatives législatives ciblées dans des pays et juridictions comme la Chine, les États-Unis et l’Union européenne.
4. Vision et réalité. L’émergence rapide de l’IA générative bouleversait et transformait l’éducation et d’autres services sociaux, alors qu’un écart important persistait entre ces évolutions et les évaluations raisonnées de sa pertinence éducative et de son utilité pratique pour les élèves locaux, en particulier les mineurs. L’opinion publique restait partagée sur ses éventuelles conséquences en matière de sécurité et d’éthique.
Le Guide pour l’IA générative dans l’éducation et la recherche de l’UNESCO, publié en septembre 2023 et désigné ci-après comme le Guide (Miao, 2023), retrace les principes de fonctionnement de la technologie et recense systématiquement huit controverses fondamentales. Il examine leurs implications éducatives et propose des réponses de gouvernance publique, des politiques éducatives et un cadre pratique d’interaction entre humains et machines adapté aux personnes concernées.
Deuxième interprétation du Guide, cette étude examine systématiquement les controverses relatives à l’IA générative et à l’éducation, en identifiant des réponses de gouvernance et des recommandations pratiques selon leurs causes et les acteurs responsables. Elle repose sur trois hypothèses interdépendantes :
Premièrement, l’innovation en IA, la sécurité et la fiabilité, ainsi que des applications sociales inclusives et égalitaires ne devraient pas constituer un trilemme. Ces trois objectifs devraient progresser ensemble et se renforcer mutuellement.
Deuxièmement, l’étude estime que les menaces les plus directes et les plus profondes concernent l’égalité et l’inclusion éducatives, la capacité d’action des apprenants, la diversité des valeurs, des langues et des cultures, ainsi que le pluralisme dans la construction des connaissances. Ces valeurs essentielles devraient donc constituer le point de départ de l’examen de la pertinence éducative de l’IA générative.
Troisièmement, les applications éducatives devraient suivre la logique consistant à « donner la priorité à la réglementation, garantir l’inclusion et orienter les applications ».
I. Les origines techniques des controverses
La discussion des controverses relatives à l’IA générative éducative doit s’appuyer sur le fonctionnement de la technologie, ses limites et ses effets sociaux observables ou potentiels.
1. Principes de fonctionnement, provenance des données d’entraînement et répartition linguistique
Le Guide définit l’IA générative à partir de la simulation, par l’IA, des systèmes symboliques représentant la pensée humaine : elle produit automatiquement des contenus en réponse à des instructions formulées au moyen de ces systèmes. Ses capacités de reconnaissance de régularités et de production de contenus se renforçaient dans le texte, la parole, les sons, les images, la vidéo et le code informatique. Dans la présentation de l’article, la génération de texte utilise des réseaux de neurones artificiels et des modèles fondés sur l’architecture Transformer, communément appelés grands modèles de langage : des systèmes d’apprentissage profond entraînés sur des informations recueillies dans des pages web, des conversations sur les réseaux sociaux et d’autres médias en ligne.
Les modèles génératifs préentraînés pour le texte ou la parole apprennent des régularités syntaxiques dans les jeux d’entraînement et acquièrent la capacité de répondre aux instructions en appliquant à répétition ces régularités au cours de cycles d’entraînement, de test et d’optimisation. Les principales étapes sont les suivantes :
1. Découper l’instruction en jetons que l’IA peut traiter et les transmettre à un transformeur génératif préentraîné. « Jeton » traduit ici token et remplace le terme inexact « octet » employé dans le texte chinois original.
2. À partir des régularités linguistiques identifiées dans les données d’entraînement, prédire la probabilité de certains mots ou groupes de mots dans leur contexte. Les prédictions statistiques combinent les mots et leurs relations syntaxiques en réponses cohérentes et prédisent les mots ou groupes de mots les plus susceptibles de suivre.
3. Convertir les mots ou groupes de mots prédits en texte lisible ou en parole intelligible. Des garde-fous filtrent les sorties manifestement illicites ou inappropriées, tandis qu’un traitement complémentaire améliore la syntaxe et la compréhension pour les rapprocher des productions humaines. Le processus se répète jusqu’à la production d’une réponse complète.
L’article explique la génération d’images et de musique principalement à l’aide des réseaux antagonistes génératifs (GAN), qui peuvent être associés à des autoencodeurs variationnels. Il mentionne aussi les modèles de diffusion comme autre méthode de génération d’images. Un GAN comporte deux éléments en compétition : un générateur et un discriminateur. En réponse à une instruction, le générateur identifie des combinaisons d’éléments visuels ou musicaux et produit une première image ou séquence musicale. Le discriminateur la compare à des exemples réels. Le générateur ajuste ensuite ses paramètres en fonction de cette comparaison. La répétition de l’entraînement sur de nombreuses itérations rend les images ou la musique générées de plus en plus réalistes.
Les capacités d’un transformeur génératif préentraîné dépendent de son architecture, de ses méthodes d’entraînement, de la qualité et de la quantité des données de préentraînement, ainsi que des paramètres du modèle. Les paramètres sont des valeurs numériques qui déterminent la manière dont les réseaux de neurones traitent les entrées et produisent les sorties, en encodant les caractéristiques apprises pendant l’entraînement. Leur définition et leur échelle influencent les performances. GPT-3 utilisait environ 175 milliards de paramètres. L’article original reprend une affirmation non confirmée selon laquelle GPT-4 en aurait « 1 800 milliards » ; le rapport technique officiel de GPT-4 n’a pas révélé la taille du modèle, comme l’expliquent les notes éditoriales.
Le paysage contemporain comprenait les produits ChatGPT d’OpenAI ; Alpaca, développé à Stanford par ajustement fin de LLaMA de Meta ; les modèles Llama de Meta ; Bard de Google, alors fondé sur PaLM 2 ; et le modèle multimodal Gemini. Les sources d’entraînement incluaient des pages web collectées par exploration, des conversations de réseaux sociaux, des livres de bibliothèques en ligne et des encyclopédies. Pour GPT-3, l’article cite un corpus estimé à environ 1 To (Thompson, 2023), composé d’environ 61,75 % de contenus Common Crawl recueillis sur internet depuis 2012 ; 18,86 % de publications et de discussions Reddit ayant reçu plus de trois votes positifs ; 15,9 % de livres de Library Genesis et Smashwords ; et 3,49 % de Wikipédia. Ce sont des estimations historiques des sources du texte, et non une description du ChatGPT actuel.
L’article souligne la prédominance des langues des États-Unis et d’Europe dans les modèles alors dominants : dans le corpus GPT-3 cité, l’anglais représentait environ 92,65 %, les autres langues européennes plus de 5 %, et le chinois moins de 0,1 %. Pour Llama 2 de Meta, l’anglais atteignait 89,7 %, le chinois 0,13 %, et les quinze autres langues principales avaient peu changé (Touvron et al., 2023). La croissance rapide des données et des paramètres exigeait aussi davantage de calcul à haute performance. Pour 2012–2019, l’article cite un doublement tous les trois à quatre mois du calcul utilisé pour entraîner les principaux modèles d’IA (Université Stanford, 2019).
2. Avancées intégrées du traitement des contenus et limites possibles de cette catégorie technologique
L’étude décrit des avancées intégrées dans les technologies centrales et complémentaires : combinaison de méthodes d’apprentissage profond, architectures optimisées, affinement d’ensembles de paramètres de l’ordre de centaines de milliards, accumulation dynamique de données d’entraînement entre plateformes et augmentation de la capacité de calcul sur des ensembles de données considérables. Ensemble, ces avancées pourraient produire un « effet d’emballement ». Premièrement, les progrès du traitement et de la présentation de l’information dans différents systèmes symboliques élargissent les capacités technologiques et accélèrent les travaux sur les puces d’IA, la superinformatique et les modèles de traitement des données.
Le caractère fondamental de ces avancées explique l’adoption générale de l’expression « modèles de fondation », proposée par des chercheurs de Stanford en 2021 (Bommasani, 2021). Deuxièmement, l’IA générative entraînait des changements dans les navigateurs, les moteurs de recherche et les infrastructures numériques, devenait un point de contrôle important de la sécurité nationale des données et de la vie privée et incitait à actualiser les réglementations et les systèmes de sécurité. Troisièmement, elle offre des outils de productivité aux activités économiques et sociales dont l’objectif direct ou indirect consiste à produire ou synthétiser des contenus, avec des transformations potentiellement importantes de la production.
L’auteur estime toutefois que sa capacité à améliorer l’efficacité et à transformer des secteurs comme l’éducation, dont les finalités dépassent la production de contenus, pourrait être fortement limitée.
En examinant les approches techniques connues à l’époque, l’auteur caractérise les réussites des réseaux de neurones comme des ajustements statistiques de courbes, distincts du raisonnement humain combinant des relations temporelles, spatiales et causales (Pearl et Mackenzie, 2018). Si l’apprentissage profond constituait la bonne voie computationnelle pour résoudre les problèmes à la manière des humains, des progrès continus pourraient finalement produire un emballement au-delà du traitement des contenus : une hypothétique singularité où l’IA dépasserait l’intelligence humaine et évoluerait selon une trajectoire relativement indépendante du contrôle humain.
Cependant, l’auteur estime que les principes alors connus des modèles de fondation semblaient rester dans les limites de la synthèse de contenus, du traitement par représentations symboliques et de la conversion des formats, plutôt que d’offrir une voie technique vers la compréhension humaine. Selon cette interprétation, ils risquent une « erreur de catégorie » (Bishop, 2021). La question restait ouverte de savoir si les progrès observés constituaient un saut de performance précédant un tel obstacle catégoriel.
II. Les controverses fondamentales autour de l’IA générative
L’article considère ces controverses comme des préoccupations humaines issues de l’interaction entre humains et machines et les examine selon des dimensions techniques et humanistes. La dimension technique suit le cycle de vie du système d’IA : production et stockage des données ; accès aux données et aux équipements de traitement et contrôle de ceux-ci ; effets observables des prédictions et décisions fondées sur les données et les algorithmes ; et IA incarnée, notamment les interfaces et dispositifs intelligents. La dimension humaniste englobe l’existence individuelle, les interactions sociales, la gouvernance nationale et les relations avec les milieux et les écosystèmes.
Ses niveaux interdépendants comprennent les individus, les groupes en interaction, les relations organisées en États souverains et les interactions entre les personnes et leur environnement (Miao, 2022). Avant une adoption à grande échelle, les utilisateurs devraient examiner la collecte et l’usage des données d’entraînement, les architectures de base et les sorties fondées sur des régularités, afin d’évaluer les menaces immédiates et les effets potentiels sur les individus, les sociétés et les pays.
1. Extraction de la productivité des données : aggravation de la pauvreté en données et de la pauvreté numérique
L’auteur considère les Avis sur la construction de systèmes fondamentaux de données pour mieux valoriser les données comme facteur de production, publiés en Chine en 2022 par le Comité central du PCC et le Conseil des affaires d’État, comme un marqueur juridique d’une ère de protection de la propriété et des droits sur les données. Dans cette perspective, collecter gratuitement les données des individus et des entreprises puis tirer profit de modèles entraînés sur ces données place au premier plan des controverses auparavant moins visibles sur l’extraction transfrontalière et intersectorielle de leur valeur.
L’accès aux données de qualité, leur utilisation et la production continue de données de qualité en ligne ou par transformation sont devenus des conditions importantes du développement économique national et des possibilités numériques des individus. Les pays qui manquent d’accès aux données, de capacités d’extraction ou de superinformatique, ainsi que les individus incapables de payer les applications de données, connaissent une « pauvreté en données » (Marwala, 2023). Selon l’auteur, entraîner des modèles de fondation à partir de données collectées gratuitement puis facturer leurs services peut aggraver cette pauvreté. Trois conditions sous-tendent cette production : l’innovation dans les architectures et méthodes d’entraînement de l’IA, des jeux de données très volumineux et une capacité de supercalcul.
À l’époque étudiée, l’auteur estimait que seuls les États-Unis, la Chine, l’UE et quelques très grandes entreprises technologiques réunissaient ces conditions. Les pays pauvres en données prenaient davantage de retard et se trouvaient exclus de la recherche centrale sur les modèles de fondation. Une adoption plus large accélère la production de données et les itérations techniques chez les acteurs dominants, renforçant le cycle de la fracture numérique.
Pour inverser ce cycle, les pays devraient identifier et corriger les faiblesses tout au long de la production des données. La « classification des causes de la pauvreté en données » proposée comprend la couverture internet, la culture numérique de toute la population, le trafic de données abordable, les talents en IA et les incitations à l’innovation, l’accès à des puces d’IA et à une superinformatique suffisamment performantes, ainsi que la possibilité d’entraîner des modèles locaux sur des données nationales ou internationales fiables. Une autre question est de savoir si des mesures internationales, comme une taxe sur l’utilisation des données, devraient redistribuer la valeur excédentaire lorsque des fournisseurs transnationaux collectent beaucoup de données dans des pays à faible revenu.
Définir et suivre le volume utilisé, calculer cette valeur et les critères de taxation, et concilier innovation et intérêts fondamentaux des populations pauvres en données resteraient des problèmes difficiles aux frontières de la gouvernance internationale des données.
2. Gouvernance dans les juridictions desservies : perte de maîtrise nationale
Les services transfrontaliers d’IA générative devraient relever de la gouvernance des juridictions qu’ils desservent, mais l’opacité technique pose des difficultés. Premièrement, les fournisseurs dominants peuvent refuser de communiquer des informations fondamentales de transparence à des organismes universitaires indépendants ou résister à leur évaluation (Bommasani, 2023). Deuxièmement, la protection de la propriété intellectuelle dans les pays d’origine des fournisseurs, principalement les États-Unis dans cette présentation, peut restreindre l’accès des pays utilisateurs aux technologies fondamentales et compliquer l’examen des systèmes et des applications (Lin, 2023).
Troisièmement, malgré les appels à suspendre le développement et à l’aligner sur la gouvernance publique, les itérations guidées par le capital avancent beaucoup plus vite que l’élaboration des réglementations, plaçant les autorités dans une forte situation de désavantage technique face aux questions juridiques et éthiques.
L’article décrit plusieurs niveaux d’absence ou de retard institutionnel. Premièrement, il indique qu’en juillet 2023, 137 pays disposaient de cadres de protection des données personnelles, ce qui en laissait près d’un tiers sans législation de base sur la vie privée (CNUCED, 2023). Deuxièmement, environ 67 pays avaient des stratégies nationales d’IA avant le Guide ; le Rwanda et la République dominicaine ont annoncé les leurs ensuite. Troisièmement, il rapporte qu’environ 40 pays seulement disposaient de politiques d’éthique de l’IA en juillet 2023. Quatrièmement, l’auteur identifie la Chine, les États-Unis et l’UE comme les juridictions qui avaient alors examiné la protection intellectuelle des œuvres synthétiques et formulé des positions claires sur leur gestion.
La Chine avait publié les Mesures provisoires pour la gestion des services d’intelligence artificielle générative avant le Guide. Les États-Unis ont publié leur décret présidentiel sur une IA sûre et digne de confiance fin octobre 2023 (The White House, 2023). Le 9 décembre 2023, les négociateurs du Parlement européen et du Conseil ont conclu un accord politique provisoire sur le règlement sur l’IA. Le texte formel relève de 2024 ; la mention originale d’une « adoption » en décembre 2023 ne doit pas être comprise comme une adoption formelle et une entrée en vigueur à cette date, ainsi que l’expliquent les notes éditoriales.
3. Droits d’auteur sur les données de préentraînement : utilisation de contenus sans autorisation
La collecte et l’utilisation de jeux de données d’entraînement suscitent d’importants différends sur l’autorisation d’utiliser les données des personnes et des organisations ainsi que les contenus protégés par le droit d’auteur.
Les modèles sont entraînés sur des textes, sons, codes, images et autres matériaux collectés sur internet. L’article soutient que les principaux modèles ont souvent collecté ces matériaux sans autorisation préalable, provoquant des différends et des litiges de propriété intellectuelle, notamment des accusations au titre de lois de protection des données comme le RGPD (Union européenne, 2016). Il souligne le cas de la presse : fin octobre 2023, la News/Media Alliance américaine, représentant plus de 2 200 éditeurs d’information, a affirmé que ChatGPT avait utilisé des millions d’articles et de reportages payants pour son entraînement sans autorisation des ayants droit, et a cherché à obtenir par des démarches juridiques le retrait de Common Crawl de contenus présumés illégalement collectés (Robertson, 2023).
Ces pratiques soulèvent aussi le droit à l’effacement, qui permet aux détenteurs de données de demander la suppression de données collectées sans autorisation. Une fois que des données personnelles ont influencé un modèle entraîné, l’auteur estime qu’en éliminer l’influence pose de grandes difficultés. Le texte original emploie des expressions absolues comme « aucune possibilité de désapprentissage » et « impossible » ; elles sont ici nuancées en tant qu’éléments de l’argumentation de l’époque. L’étude citée traite du désapprentissage automatique, de l’édition des modèles et d’autres approches, comme l’expliquent les notes éditoriales. Le problème comprend l’élimination de réponses apprises qui reflètent les opinions et les caractéristiques linguistiques ou culturelles du détenteur des données (Zhang, 2023).
4. Explicabilité de l’architecture : sorties de modèles opaques
L’article décrit les architectures de réseaux de neurones comme des boîtes noires dont il est difficile d’expliquer les configurations de nœuds et de couches, la définition des paramètres et les calculs. Les progrès récents amplifient ces inquiétudes. Même si l’approche générale, y compris les algorithmes, est partiellement explicable, il est difficile de rendre compte de paramètres particuliers et de leurs contributions respectives à une sortie. Les grands modèles de fondation mobilisent de vastes ensembles de paramètres et de poids pour reconnaître des régularités et produire des réponses, ce qui complique l’explication d’une réponse précise d’un modèle donné. L’auteur s’attend à ce que l’augmentation de l’échelle et de la complexité architecturale aggrave ce problème.
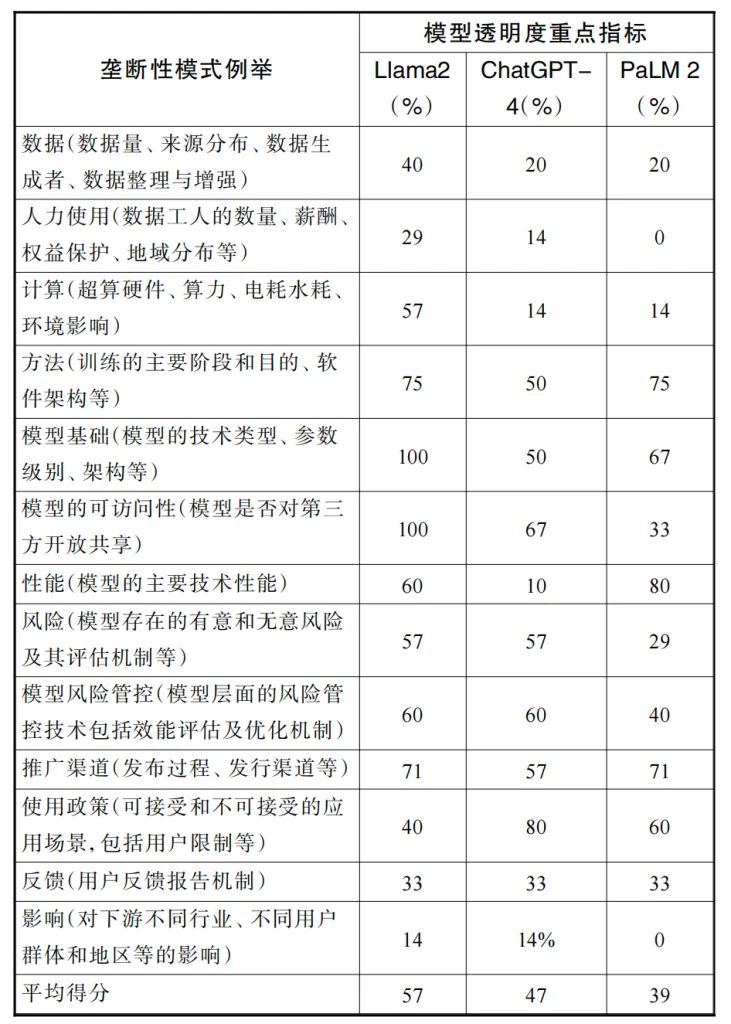
Les limites techniques de l’explicabilité se combinent à la réticence des fournisseurs à divulguer les informations pertinentes, entravant les régulateurs et les chercheurs indépendants qui évaluent les risques intentionnels et les dommages involontaires. L’Indice de transparence des modèles de fondation de Stanford (Bommasani, 2023) évalue des éléments techniques importants des principaux modèles. L’article renvoie à une comparaison d’environ dix grands modèles et reproduit dans le tableau 1 des indicateurs choisis pour trois exemples majeurs. Il soutient que l’opacité des modèles et les risques difficiles à détecter rendent les erreurs difficiles à retracer et limitent l’évaluation et la prévention transparentes. Il cite des experts déconseillant l’usage de l’IA générative pour des tâches à haut risque.
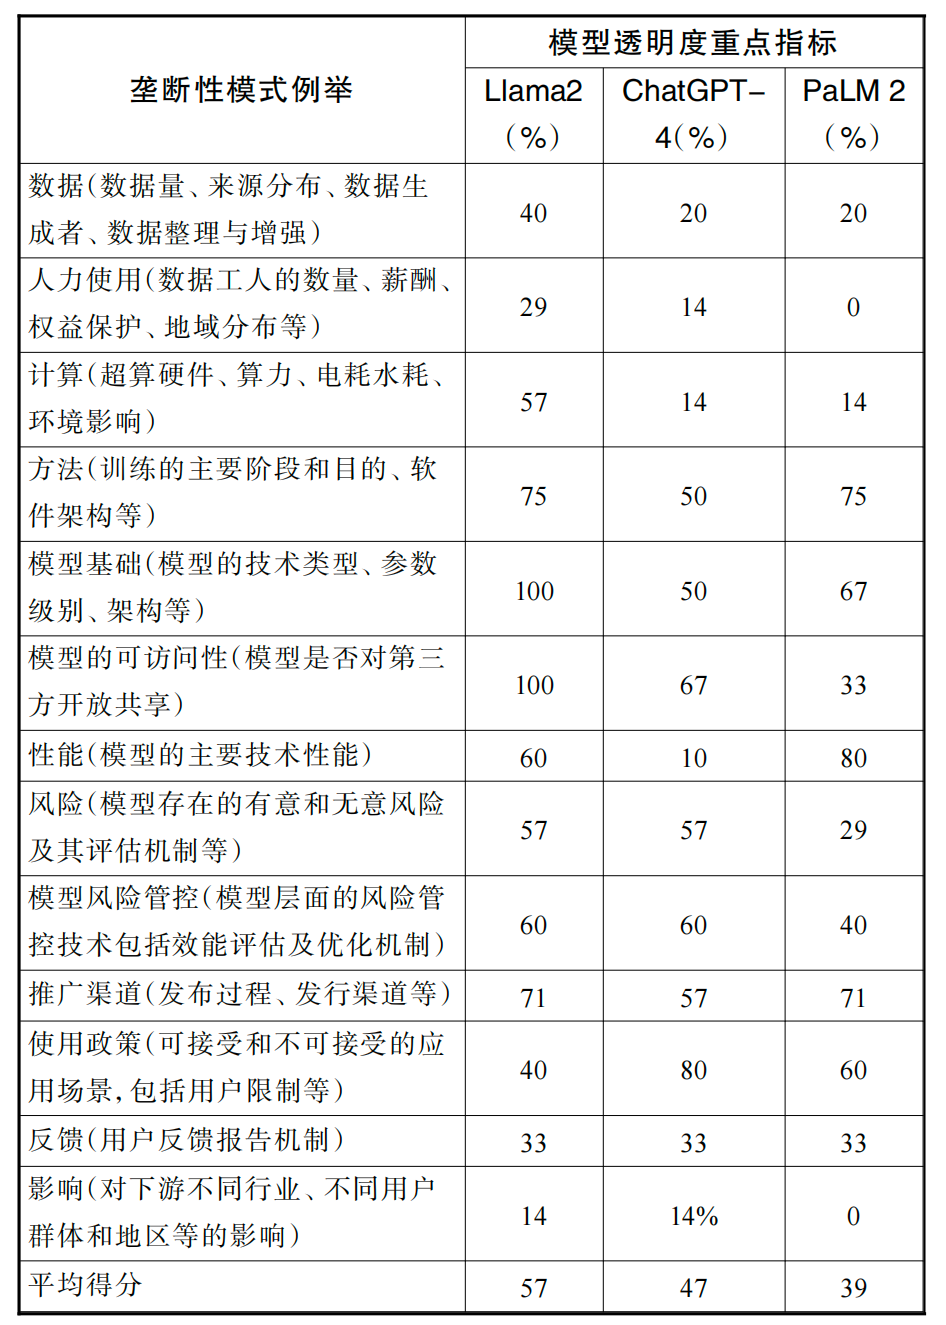
| Indicateur | Llama 2 | ChatGPT-4 (appellation de la revue) | PaLM 2 |
|---|---|---|---|
| Données : volume, répartition des sources, producteurs, sélection et enrichissement | 40 | 20 | 20 |
| Travail : nombre de travailleurs des données, rémunération, droits et répartition géographique | 29 | 14 | 0 |
| Calcul : matériel, capacité, électricité, eau et effets environnementaux | 57 | 14 | 14 |
| Méthodes : principales étapes d’entraînement, finalités et architecture logicielle | 75 | 50 | 75 |
| Bases du modèle : techniques, échelle des paramètres et architecture | 100 | 50 | 67 |
| Accès au modèle : disponibilité et partage avec des tiers | 100 | 67 | 33 |
| Performance : principales capacités techniques | 60 | 10 | 80 |
| Risques : risques intentionnels et involontaires et mécanismes d’évaluation | 57 | 57 | 29 |
| Réduction des risques du modèle : évaluation et optimisation | 60 | 60 | 40 |
| Distribution : processus de publication et canaux | 71 | 57 | 71 |
| Politiques d’utilisation : usages autorisés et interdits et restrictions des utilisateurs | 40 | 80 | 60 |
| Retours : mécanismes de signalement par les utilisateurs | 33 | 33 | 33 |
| Impact : secteurs en aval, groupes et régions | 14 | 14 | 0 |
| Score moyen imprimé dans l’original | 57 | 47 | 39 |
5. Compréhension : sémantique et monde réel
L’IA générative reconnaît des régularités contextuelles de manière probabiliste et produit du texte selon une syntaxe apprise. L’auteur relie une compréhension sémantique limitée aux hallucinations comportant des erreurs factuelles, historiques et scientifiques. Un classement historique de Vectara hébergé sur GitHub, mis à jour pour la dernière fois le 1er novembre 2023, indiquait des taux d’hallucination propres à la tâche de 3 % à 3,5 % pour les modèles GPT, de 5,1 % à 5,9 % pour Llama et de 12,1 % pour Google PaLM. Ces taux concernaient la fidélité de résumés de documents, et non l’exactitude de réponses à des questions générales. L’article suppose aussi que les erreurs seraient plus élevées en chinois et dans d’autres langues, mais ce classement n’établit pas une telle comparaison linguistique.
Des élèves sans connaissances fondamentales solides peuvent donc apprendre à partir de contenus incertains lors de conversations autonomes. Selon l’auteur, ces systèmes ne devraient pas être traités comme des sources fiables de contenus pédagogiques. Il distingue aussi le traitement de régularités syntaxiques de la compréhension des objets et relations du monde réel, des relations humaines et sociales, et des relations entre personnes, objets et technologies. La découverte scientifique repose, rappelle-t-il, sur l’observation du monde, l’expérimentation et le raisonnement, alors que l’IA générative synthétise surtout les publications antérieures. Selon lui, des connaissances nouvelles nécessitent une capacité d’action humaine avec l’IA comme assistance.
Le texte original tire aussi une conclusion sur la « connaissance » à partir des débats de droit d’auteur ; la protection juridique et la définition de la connaissance ne doivent pas être confondues. S’appuyant sur Candelon (2023), l’article met également en doute la capacité des modèles à proposer des solutions ciblées et innovantes à des problèmes complexes du monde réel ou à émettre des jugements de valeur sociale. Il conclut qu’ils ne devraient pas guider seuls l’apprentissage de connaissances complexes ni la résolution de problèmes mal structurés sans enseignants humains.
Ces limites restreignent, selon l’auteur, la transformation éducative positive en matière de contenus fondamentaux, de pensée de haut niveau, de résolution de problèmes complexes, de valeurs et de développement humain. L’IA générative peut agir en partie en remettant en cause de l’extérieur les acquis d’apprentissage et l’évaluation : l’automatisation du traitement des contenus et l’externalisation plus difficile à détecter diminuent la valeur de la synthèse et de la production élémentaires comme résultats centraux. Une part moindre d’exercices de base en orthographe et en syntaxe, de synthèses bibliographiques, de création de diapositives et de productions artistiques élémentaires dans les évaluations formatives et à faibles enjeux pousserait les systèmes à reconsidérer leurs priorités d’apprentissage et leurs méthodes d’évaluation.
6. Pollution par l’information générée : contenus synthétiques sur internet
L’article identifie deux formes de pollution liées à la production et à la diffusion de contenus d’IA générative.
Premièrement, les modèles peuvent reproduire des matériaux nuisibles appris sur internet, notamment la désinformation, la discrimination et les discours de haine, puis les diffuser de nouveau en ligne. Cette circulation répétée peut nuire à des apprenants de différents âges de manière difficilement réversible.
Deuxièmement, un internet de plus en plus rempli de matériaux synthétiques affecte l’entraînement des modèles suivants. Un apprentissage profond de qualité dépend de données humaines diverses et de formes d’expression variées permettant d’apprendre différents motifs. Lorsque les contenus générés par des machines sont largement remis en circulation, les modèles ultérieurs peuvent être entraînés sur les sorties des précédents. Dans le processus décrit, les événements très probables deviennent surreprésentés et les événements peu probables sous-représentés, effaçant progressivement la longue traîne statistique. Celle-ci contribue à préserver l’exactitude et la diversité.
Sa disparition peut renforcer les régularités déjà apprises et produire des sorties de plus en plus homogènes, proches des matériaux synthétiques plutôt que du réel, accroître les erreurs et potentiellement provoquer un effondrement des modèles. Cela pose de nouveaux défis pour obtenir des données d’entraînement de qualité sur internet (Lutkevich, 2023).
7. Projection de valeurs : homogénéisation et effacement linguistique et culturel
La projection de valeurs similaires à travers les sorties générées peut évincer les groupes numériquement défavorisés, le pluralisme dans la construction éducative des connaissances et l’expression de différents points de vue.
Lorsqu’une séquence apparaît fréquemment dans les données d’entraînement, un Transformer a davantage de chances de la reproduire, ainsi que des phrases apparentées. L’article soutient que les croyances communes et les perspectives des médias dominants dans les jeux de données américains et européens peuvent devenir les « réponses standard » des modèles, renforçant par rétroaction des valeurs et des conventions linguistiques ou culturelles déjà puissantes. Une adoption sans esprit critique et sans examen de l’origine des données peut consolider des stéréotypes culturels.
Il cite Omiye (2023), dont les tests répétés de ChatGPT/GPT-3.5, GPT-4, Bard et Claude d’Anthropic ont trouvé des réponses biaisées reflétant des stéréotypes raciaux sur la capacité pulmonaire, le débit de filtration glomérulaire estimé, l’épaisseur de la peau et la taille du cerveau. Ce sont des exemples de biais nocifs des modèles, et non des affirmations biologiques validées. À l’inverse, les groupes marginalisés et pauvres en données laissent moins de traces en ligne et sont peu représentés dans les données d’entraînement ; leurs valeurs et pratiques linguistiques et culturelles sont donc mal reconnues. Selon l’auteur, des modèles localement pertinents qui soutiennent la diversité sont importants pour les langues et cultures autochtones et les intérêts légitimes des groupes défavorisés (Miao, 2023).
Une dépendance excessive à l’IA générative pour les « réponses standard » et les solutions peut aussi réduire la diversité des idées et affaiblir l’innovation. Dans l’étude du Boston Consulting Group citée, portant sur plus de 750 participants, les idées produites avec GPT-4 étaient présentées comme 41 % moins diverses que celles produites sans lui. Les participants montraient souvent peu d’inclination à élargir la diversité après avoir reçu les propositions du modèle. Dans la même étude, 70 % exprimaient la crainte qu’un usage prolongé de l’IA générative pour obtenir des réponses n’érode la créativité humaine (Candelon, 2023). Ces résultats relèvent du contexte de cette étude.
8. Hypertrucages illicites : création et diffusion facilitées
L’IA générative abaisse les barrières de compétence et de coût à la production d’hypertrucages illicites, tout en compliquant leur détection et en facilitant leur création et leur circulation.
L’article explique comment des personnes sans compétences journalistiques, musicales ou de production vidéo peuvent employer des contenus synthétiques pour usurper l’identité de personnes réelles, propager de fausses informations ou de la haine, diffamer, manipuler des images et vidéos existantes ou poursuivre d’autres buts illicites. L’auteur oppose les bénéfices incertains pour résoudre des problèmes d’intérêt général à l’accessibilité des outils à des fins malveillantes. Le rapport State of Deepfakes de 2023 cité (Home Security Heroes, désormais Security Hero) affirmait qu’un hypertrucage sexuellement explicite de soixante secondes pouvait être généré gratuitement à partir d’une seule image nette du visage en moins de vingt-cinq minutes.
Il analysait 95 820 vidéos et décrivait une hausse de 550 % par rapport à 2019 ; les mentions originales de « près d’un million de nouvelles vidéos » et de « 5,5 fois » sont corrigées d’après cette source. Ces chiffres relèvent de l’enquête du rapport, et non d’un recensement mondial vérifié ou d’un total actuel. Selon le rapport, 98 % des vidéos truquées étudiées étaient pornographiques et 99 % des personnes ciblées dans cette catégorie étaient des femmes.
III. Recommandations en matière de réglementation
Pour répondre à ces controverses tout en développant le potentiel éducatif, le Guide propose des principes centrés sur l’humain pour le développement et l’utilisation de l’IA. Sa démarche consistant à « donner la priorité à la réglementation, garantir l’inclusion et orienter les applications » vise des usages éthiques, sûrs, fiables, équitables, inclusifs et porteurs de sens.
1. Une approche de la gouvernance et de l’application de l’IA centrée sur l’humain
Depuis 2019, l’UNESCO défend une recherche et des applications de l’IA centrées sur l’humain, explicitées notamment dans la Recommandation sur l’éthique de l’intelligence artificielle (citée comme UNESCO, 2022), le Consensus de Beijing sur l’intelligence artificielle et l’éducation (UNESCO, 2019) et IA et éducation : Guide pour les décideurs politiques (cité comme Miao, 2022). Dans cette présentation, la gouvernance et l’usage doivent protéger les droits fondamentaux, la dignité et la diversité culturelle, parallèlement à une conception biocentrique des relations harmonieuses entre les personnes, les milieux et les écosystèmes. Le développement doit servir les personnes et renforcer les capacités d’une coopération efficace entre humains et machines.
Tout au long de la conception, du développement, de l’usage et des itérations, la capacité d’action humaine doit rester centrale, avec fiabilité, adaptation aux personnes et aux finalités, explicabilité, contrôle humain et responsabilité humaine (Miao, 2022).
2. Une feuille de route pour la gouvernance de l’IA générative
Le Guide recommande une gouvernance collaborative mobilisant l’ensemble du gouvernement et précisant les droits, les pouvoirs, les responsabilités et les obligations des acteurs de tous les secteurs et branches d’activité.
2.1 Négocier des instruments internationaux, notamment des règles de protection transfrontalière des données
Des règles de protection des données mutuellement reconnues et des mécanismes de gouvernance transfrontalière sont proposés comme préalables pour combler les lacunes de juridiction. Le RGPD offre un exemple de cadre juridique pour gouverner des services de données transfrontaliers.
2.2 Établir des stratégies d’IA à l’échelle du gouvernement et une gouvernance éthique intersectorielle
Une stratégie mobilisant l’ensemble du gouvernement peut coordonner la gouvernance de l’IA entre secteurs et ministères. Les mécanismes de gouvernance éthique devraient préciser la souveraineté nationale sur les données ; les droits sur les données et la vie privée des institutions et des individus ; les relations licites dans la production de données ; les principes fondamentaux du développement et de l’usage de l’IA ; et la répartition de la valeur excédentaire des produits d’IA construits à partir de données publiques ou appartenant à autrui.
2.3 Élaborer des règles visant spécifiquement l’IA générative
La Chine a publié les Mesures provisoires pour la gestion des services d’intelligence artificielle générative en juillet 2023. L’auteur les présentait comme les premières règles formelles au monde de gouvernance juridictionnelle des services d’IA générative, un jugement comparatif formulé dans le contexte historique du texte original. Il proposait d’affiner leurs dispositions juridiques et éthiques à l’aide du Guide et des initiatives européennes et américaines de l’époque. Les points suivants concernaient particulièrement l’éducation :
1. Classer les risques de sécurité technique et réglementer selon leur niveau. La présentation de l’article du projet européen de règlement sur l’IA alors débattu distingue les risques inacceptables, dont les technologies manipulant les mineurs pour créer une dépendance, la reconnaissance des émotions et certaines prédictions de l’intelligence ou des comportements ; les risques élevés ; les risques limités ; et les risques minimaux. Elle décrit des réponses allant de l’interdiction du développement et de la commercialisation à une surveillance intensive, des examens et des contrôles, jusqu’à l’autorégulation professionnelle. L’éducation était identifiée comme un domaine à examiner étroitement. Il s’agit des catégories discutées dans le texte historique, et non d’un exposé de toutes les dispositions du règlement adopté ultérieurement.
2. Prévoir des protections d’âge pour les conversations autonomes avec l’IA générative. Les modèles conversationnels pouvant produire des contenus inadaptés aux mineurs, le Guide recommande treize ans comme seuil minimal d’usage autonome, tout en envisageant un seuil plus strict de seize ans. À mesure que les services passent de conversations sur des plateformes à des applications sur des appareils personnels, les régulateurs et les adultes peuvent avoir plus de mal à superviser l’usage indépendant. L’auteur appelle à évaluer ces risques et à clarifier les responsabilités de surveillance de l’usage par les mineurs. La dernière mention des « adultes » dans le paragraphe original est corrigée selon le contexte en « mineurs ». Treize et seize ans sont des recommandations discutées, et non un âge légal universel pour converser avec une IA.
3. Préciser les responsabilités des autres acteurs. L’article oppose les Mesures chinoises, centrées sur les fournisseurs, aux responsabilités institutionnelles plus étendues décrites dans le décret présidentiel américain de 2023. Il propose des obligations pour les institutions qui achètent et déploient des systèmes d’IA : vérifier conjointement la légalité des données, des outils et des services de contenus, et contribuer à surveiller les effets changeants sur les utilisateurs, en particulier les groupes défavorisés. Une fois les responsabilités institutionnelles précisées, il faudrait aussi considérer les obligations des utilisateurs individuels : sensibilisation et capacités pour reconnaître les menaces et se protéger, connaissances et compétences pour utiliser légalement les outils et les contenus générés.
4. Clarifier l’identification, le droit d’auteur et les usages autorisés des contenus générés. Les Mesures chinoises imposent aux fournisseurs de signaler les images et vidéos générées conformément aux règles relatives aux services d’information sur internet de synthèse profonde. L’original attribue aussi le signalement des contenus d’IA au RGPD ; le droit de la protection des données doit être distingué de la législation sur la transparence de l’IA, comme l’expliquent les notes éditoriales. L’auteur estime que les trois cadres de l’époque étudiés ne résolvaient pas toutes les questions d’usage légitime des produits générés.
Restait notamment à limiter les hypertrucages illicites ; à définir et protéger les droits des utilisateurs payants sur les contenus générés ; et à distinguer la synthèse bibliographique assistée par IA dans une recherche dirigée par des humains de la tricherie contraire à l’éthique universitaire ou aux règles pédagogiques.
IV. Recommandations politiques et pratiques pour les usages éducatifs
Le Guide formule des recommandations détaillées pour des applications éducatives efficaces. L’article souligne les suivantes :
1. Garantir l’inclusion, l’équité et la diversité linguistique et culturelle
La relation entre l’IA générative et les principes centrés sur l’humain a quatre implications. Premièrement, un accès et des possibilités équitables sont des préalables à l’inclusion éducative : chacun doit avoir des possibilités indépendamment du genre, de l’origine ethnique, des capacités, du statut socioéconomique ou du lieu de résidence fixe. Les pays devraient utiliser la classification proposée des causes de la pauvreté en données pour identifier les groupes exclus et remédier à des lacunes précises. Deuxièmement, des financements spécifiques devraient soutenir des outils pour les apprenants tout au long de la vie de différents âges et capacités, y compris les personnes ayant des besoins particuliers d’apprentissage.
Troisièmement, l’évaluation devrait examiner les biais dans les sources de données, le prétraitement, la conception des modèles et les sorties, notamment les biais de genre, les stéréotypes visant certains groupes, la discrimination des personnes marginalisées et les discours de haine. Quatrièmement, les indicateurs de diversité linguistique et culturelle devraient soutenir les langues minoritaires et autochtones dans les données de préentraînement, les architectures et les méthodes d’entraînement, en évitant leur exclusion ou l’introduction de filtrages et de post-traitements biaisés.
2. Protéger la capacité d’action humaine
À mesure que l’IA générative devient plus performante et automatise partiellement le traitement élémentaire des contenus, ses usages éducatifs peuvent affaiblir la capacité d’action. Produire facilement des dissertations ou des œuvres artistiques de base peut encourager une dépendance aux contenus générés de l’extérieur, réduisant les occasions d’exercer son esprit et de développer les connaissances et compétences fondamentales. Protéger et renforcer cette capacité doit donc être au cœur de la conception et de l’adoption : l’IA peut mettre au défi et élargir la pensée humaine, mais ne doit pas se l’approprier. Le Guide propose sept garanties. Premièrement, expliquer quelles données des élèves sont recueillies, leur utilisation et leurs effets possibles sur la vie éducative et sociale.
Deuxièmement, protéger la motivation intrinsèque et l’autonomie humaine dans les décisions et les actions d’enseignement et d’apprentissage assistés par IA. Troisièmement, préserver les occasions de développer la cognition et les compétences sociales par l’observation du réel, des méthodes empiriques comme l’expérimentation et la discussion, et le raisonnement logique. Quatrièmement, garantir les interactions sociales et le contact avec les œuvres humaines, en évitant la dépendance excessive ou l’addiction. Cinquièmement, consulter chercheurs, enseignants et élèves avant une adoption à grande échelle. Sixièmement, encourager la remise en question des méthodes techniques, de l’exactitude, des valeurs incorporées et des effets pédagogiques.
Septièmement, enseignants et élèves doivent conserver la responsabilité des décisions prises avec l’assistance de l’IA.
3. Examiner et surveiller les outils éducatifs d’IA et développer des modèles de fondation adaptés au contexte local
L’éthique dès la conception et une approche du cycle de vie doivent guider le développement et le déploiement, en protégeant apprenants, enseignants et relations éducatives contre les risques techniques ou éthiques prévisibles et les outils inadaptés. Pour les systèmes existants, le Guide recommande examen, admission et surveillance continue. Les contrôles éthiques devraient examiner la réduction des biais, en particulier de genre, et la représentativité linguistique et culturelle des données. Avant leur autorisation, les systèmes devraient éviter les dommages prévisibles, démontrer une valeur éducative, convenir à l’âge et aux capacités des apprenants et respecter les principes institutionnels relatifs aux connaissances, compétences, résultats attendus et valeurs.
L’utilisation des données et l’autorisation des services nécessitent une information compréhensible sur les risques, les dispositions de tutelle applicables, une communication adaptée à l’âge, l’accessibilité et un consentement valable. Le handicap ne détermine pas à lui seul la capacité juridique ; les notes éditoriales expliquent la correction de la catégorisation générale de l’original à partir de l’article 12 de la Convention relative aux droits des personnes handicapées. Les examens devraient aussi vérifier les hypertrucages, les fausses informations, les discours de haine et les autres sorties nuisibles ou illicites, et étudier les coûts environnementaux, notamment l’électricité et l’eau utilisées pour entraîner les modèles, dans le contexte local.
L’article constate des lacunes dans l’adéquation culturelle et linguistique des modèles alors dominants au-delà des États-Unis et de l’Europe. Tout en respectant une concurrence internationale licite, il recommande un développement actif pour améliorer l’adaptation locale : soutenir des modèles de fondation nationaux sûrs et maîtrisables, avec des arrangements appropriés sur les droits ; développer et tester de façon itérative des transformeurs génératifs préentraînés éducatifs, ou modèles EdGPT, fondés sur les valeurs locales, la diversité linguistique et culturelle et les normes des programmes ; et créer des incitations pour les plateformes et extensions qui favorisent l’investigation et des choix variés d’apprentissage.
L’objectif est un écosystème où modèles de fondation et applications éducatives en aval se développent ensemble autour des langues, cultures et programmes locaux.
4. Développer les compétences en IA des enseignants et des élèves
Les compétences en IA, notamment chez les élèves, sont essentielles à des usages sûrs, éthiques et porteurs de sens. L’article indique qu’à la mi-2022, seuls quinze pays environ disposaient de programmes scolaires d’IA approuvés au niveau national (UNESCO, 2022), ce qui rendait plus urgente une culture fondamentale de l’IA pour tous. Le cadre pour les élèves alors en cours d’élaboration organisait les compétences par dimensions et niveaux, en associant apprentissages scolaires et extrascolaires. Ses dimensions étaient une conception de l’IA centrée sur l’humain, l’éthique de l’IA, les techniques et applications fondamentales et la conception de systèmes d’IA. Les niveaux comprendre, appliquer et créer décrivaient les connaissances, compétences et attitudes. Le tableau 2 conserve ce projet historique.
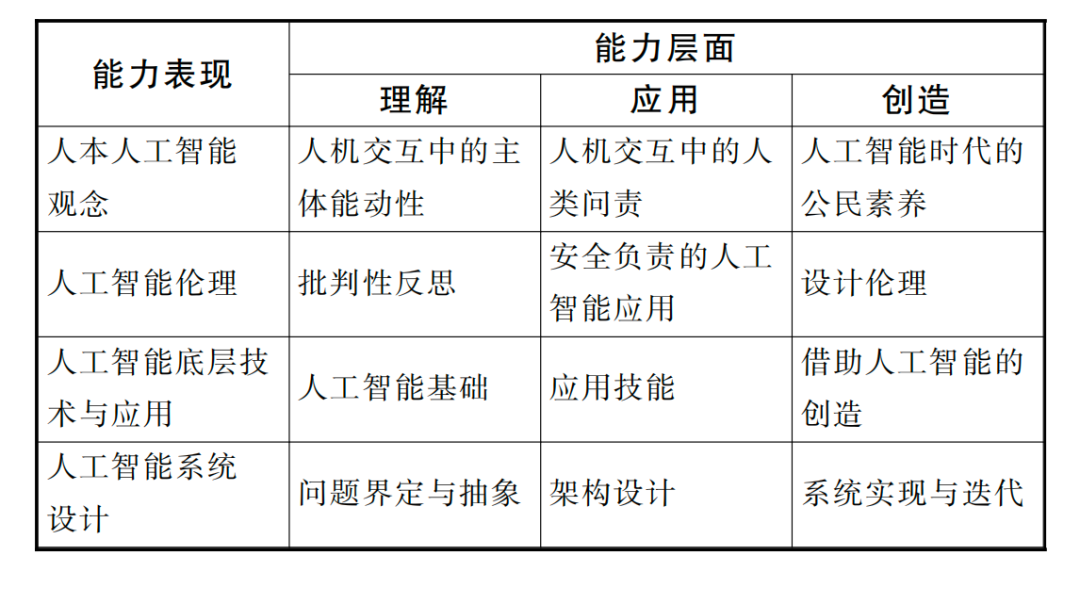
| Dimension de compétence | Comprendre | Appliquer | Créer |
|---|---|---|---|
| Conception de l’IA centrée sur l’humain | Capacité d’action dans l’interaction humain–IA | Responsabilité humaine dans l’interaction humain–IA | Citoyenneté à l’ère de l’IA |
| Éthique de l’IA | Réflexion critique | Usage sûr et responsable de l’IA | Éthique dès la conception |
| Fondements et applications de l’IA | Fondements de l’IA | Compétences d’application | Création avec l’IA |
| Conception des systèmes d’IA | Définition et abstraction du problème | Conception de l’architecture | Mise en œuvre et itération |
L’UNESCO élaborait aussi un cadre pour les enseignants, destiné à orienter les normes et les formations nationales vers un usage approprié ; le tableau 3 le présente dans sa version de travail historique originale. Ses cinq dimensions étaient une conception de l’IA centrée sur l’humain, l’éthique de l’IA, les fondements et applications, l’intégration de l’IA à la pédagogie et le développement professionnel soutenu par l’IA. Trois niveaux — acquisition, approfondissement et création — décrivaient les résultats pour des enseignants ayant différents points de départ. L’acquisition concernait tous les enseignants après formation, y compris ceux sans préparation préalable en IA et ceux exerçant dans des milieux peu dotés. L’approfondissement visait les enseignants ayant des connaissances et une expérience intermédiaires.
La création visait un niveau expert chez des enseignants disposant de connaissances étendues et d’une forte expérience d’application de l’IA.
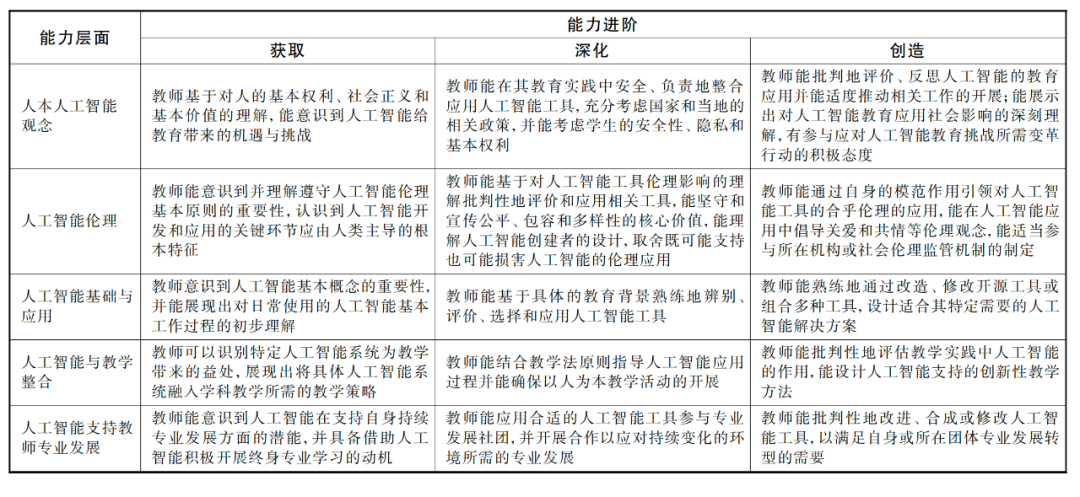
| Dimension de compétence | Acquérir | Approfondir | Créer |
|---|---|---|---|
| Conception de l’IA centrée sur l’humain | Reconnaître les possibilités et les défis éducatifs de l’IA à partir d’une compréhension des droits fondamentaux, de la justice sociale et des valeurs essentielles. | Intégrer les outils d’IA de manière sûre et responsable dans la pratique éducative, en tenant compte des politiques nationales et locales ainsi que de la sécurité, de la vie privée et des droits fondamentaux des élèves. | Évaluer de manière critique les usages éducatifs de l’IA et y réfléchir, faire avancer les travaux pertinents de façon appropriée, comprendre leurs effets sociaux et participer positivement aux changements nécessaires pour relever les défis. |
| Éthique de l’IA | Comprendre l’importance des principes éthiques et reconnaître les considérations centrées sur l’humain tout au long du développement et de l’utilisation. | Évaluer et adapter les outils de manière critique selon leurs effets éthiques ; défendre l’équité, l’inclusion et la diversité, et comprendre comment les choix de conception et les arbitrages des développeurs peuvent soutenir ou compromettre un usage éthique. | Donner l’exemple d’un usage éthique, promouvoir et partager des idées éthiques et participer à l’établissement d’une supervision de l’éthique de l’IA dans les institutions ou la société. |
| Fondements et applications de l’IA | Reconnaître les concepts fondamentaux importants et montrer une première compréhension du fonctionnement des outils d’IA du quotidien. | Identifier, évaluer, sélectionner et utiliser avec compétence des outils dans des contextes éducatifs précis. | Sélectionner ou développer et adapter des outils libres, ou combiner des outils, pour concevoir des solutions d’IA répondant à des besoins particuliers. |
| Intégration de l’IA et de la pédagogie | Identifier les bénéfices pédagogiques d’un système et montrer des stratégies pour l’intégrer à l’enseignement d’une discipline. | Orienter les applications d’IA à l’aide de principes pédagogiques et garantir des activités d’apprentissage centrées sur l’humain. | Évaluer de manière critique le rôle de l’IA dans la pratique enseignante et concevoir des pédagogies innovantes soutenues par l’IA. |
| Développement professionnel soutenu par l’IA | Reconnaître le potentiel de l’IA pour le développement professionnel continu et entretenir la motivation pour un apprentissage professionnel tout au long de la vie avec son aide. | Utiliser des outils adaptés pour participer à des communautés professionnelles et collaborer au développement dans des environnements changeants. | Adapter, combiner ou modifier de manière critique les outils pour répondre aux besoins de développement professionnel personnels ou communautaires. |
5. Encourager un enseignement créatif, une construction pluraliste des connaissances et une expression diverse
L’éducation entretient la civilisation et son développement continu par la diversité linguistique et culturelle, la construction individuelle du sens et des formes d’expression variées. Selon l’auteur, reproduire les visions du monde des propriétaires des données d’entraînement peut évincer d’autres perspectives et menacer cette mission. L’IA générative ne devrait donc être traitée comme une source de savoir faisant autorité dans aucune discipline. Enseignants et élèves devraient évaluer ses sorties de manière critique, en reconnaissant leur utilité pour retrouver rapidement des informations, chercher des publications et convertir des formats, tout en s’attendant à des contenus peu fiables.
L’enseignement devrait être adapté aux apprenants, les encourageant à évaluer les valeurs projetées et les présupposés culturels et à utiliser la synthèse bibliographique et le traitement des données pour enquêter. Les élèves ont aussi besoin d’occasions suffisantes d’essais et d’erreurs sans IA, d’expérimentation empirique et d’observation du monde réel.
6. Étudier les effets éducatifs à long terme entre disciplines et secteurs
Si cette étude retrace les processus et limites connus, les modèles de fondation et les applications en aval évoluant rapidement interagissent avec des situations éducatives extrêmement variées et incertaines. Leur portée éducative ne devrait pas être évaluée de façon étroite à partir des défauts existants ou d’un point de vue exclusivement sceptique. Le Guide appelle à une collaboration entre chercheurs et fournisseurs d’IA, théoriciens de l’éducation, chercheurs en neurosciences cognitives et autres domaines, enseignants, élèves et parents.
Ensemble, ils devraient examiner les effets à long terme sur la production et l’apprentissage des connaissances, le droit d’auteur et la recherche, les programmes et l’évaluation, la coopération humaine et le développement social, puis reconsidérer prudemment les cadres curriculaires, les objectifs éducatifs et les examens, et ajuster le système en conséquence.
L’évaluation du potentiel éducatif d’une avancée technologique majeure dans le traitement des contenus ne devrait ni commencer ni se terminer avec les promesses commerciales ou les gains de productivité de la création de contenus. Le point de départ reste les principes centrés sur l’humain. Les éducateurs devraient examiner les controverses sur tout le cycle de vie de l’IA et traiter leurs implications pour l’équité, l’inclusion, les valeurs et la diversité linguistique et culturelle. Selon la conclusion de l’auteur, cela est nécessaire pour éviter que les individus et les communautés, participants et bénéficiaires de l’éducation, ne deviennent les sujets d’expérimentation ou les serviteurs d’une IA guidée par des intérêts commerciaux.
Références
- Bishop, J. M.(2021). Artificial Intelligence is stupid and causal reasoning won't fix it[J]. Frontier in Psychology, 2021(11):1-18.
- Bommasani, R., Hudson, D. A., Adeli, E., et al (2021). On the opportunities and risks of foundation models[DB/OL]. [2023-10-16]. https://crfm.stanford.edu/report.html.
- Bommasani, R., Klyman, K., Longpre, S. et al.(2023). The foundation model transparency index.[DB/OL]. [2023-10-10]. https://arxiv.org/abs/2310.12941.
- Candelon, F., Krayer, L., Rajendran,S. et al.(2023). How people can create and destroy value with generative AI[DB/OL]. [2023.10-12]. https://www.bcg.com/publications/2023/how-people-create-and-destroy-value-with-gen-ai.
- European Parliament(2023). MEPs ready to negotiate first-ever rules for safe and transparent Al. [DB/OL. [2023-10-18]. https://digital-strategy.ec.europa.eu/en/policies/european-approach-artificial-intelligence.
- European Union(2016). General Data Protection Regulation[DB/OL].[2023-08-09]. http://data.europa.eu/eli/reg/2016/679/oj.
- GitHub(2023). Hallucination Leaderboard. [DB/OL]. [2023-11-08]. https://github.com/vectara/hallucination-leaderboard.
- Home Security Hero(2023). State of deepfakes: Realities,threats, and impact [DB/OL].[2023-11-11]. https://www.homesecurity-heroes.com/state-of-deepfakes/#key-findings.
- Lin, B.(2023). Al is generating security risks faster than companies can keep pp.[DB/OL].[2023-08-25]. https://www.wsj.com/articles/ai-is-generating-security-risks-faster-thancompanies-can-keep-up-a2bdedd4.
- Lutkevich, B.(2023). Model collapse explained: How synthetic training data breaks AI [DB/OL].[2023-10-28]. https://www.techtarget.com/whatis/feature/Model-collapse-explained-How-synthetic-training-data-breaks-AI.
- Marwala, T(2023). Algorithm Bias: Synthetic Data Should Be Option of Last Resort When Training Al Systems.[DB/OL]. [2023-07-31].https://unu.edu/article/algorithm-bias-synthetic-data-should-be-option-last-resort-when-training-ai-systems.
- Miao, F.(2022). Al and education: Guidance for policymakers|M]. Paris, UNESCO.
- Miao, F.et al(2023). Guidance on generative Al in education and research [M]. Paris: UNESCO 2023.
- 苗逢春(2022). 教育人工智能伦理的解析与治理: 人工智能伦理问题建议书的教育解读[J].中国电化教育,2022(6):22-36.
- 苗逢春(2023). 数字文明变局中的教育数字化转型[J].电化教育研究,(2):47-63,91.
- Omiye, J. A., Lester, J.C., Spichak, S. et al.(2023). Large language models propagate race-based medicine[J]. Digital Medicine, 2023(6):195:1-4.
- Pearl, J.,& Mackenzie, D.(2018). The book of why: The new science of cause and effect [M]. NY: Basic Books.
- Robertson, K.(2023). News group says A. I. Chatbots heavily rely on news content [EB/OL]. The New York Times. https://www.nytimes.com/2023/10/31/business/media/news-artificial-intelligence-chatbots.html.
- Stanford University(2019). The 2019 Al Index Report[DB/OL].[2023-1018]. https://hai.stanford.edu/ai-index-2019.
- The White House(2023). Executive order on the safe, secure, and trustworthy development and use of artificial intelligence [OL] The White House. https://www.whitehouse.gov/briefing-room/presidential-actions/2023/10/30/executive-order-on-the-safe-secure-and-trustworthy-development-and-use-of-artificial-intelligence/.
- Thompson, A. D.(2023). Contents of GPT-3 & the pile v1[EB/OL].[2023-1018]. https://lifearchitect.ai/models/#gpt-3-top-10.
- Touvron H, Martin, L, Stone, K et al.(2023) Llama 2: Open foundation and fine-tuned chat models[DB/OL][2023-10-16]. https://ai.meta.com/research/publications/llama-2-open-foundation-and-fine-tuned-chat-models.
- UNCTAD(2023). Data protection and privacy legislation worldwide [DB/OL].[2023-07-18]. https://unctad.org/page/data-protection-and-privacy-legislation-worldwide.
- UNESCO(2019). Beijing consensus on artificial intelligence and education[S].Paris, UNESCO.
- UNESCO(2022). Recommendation on the Ethics of Artificial Intelligence[S]. Paris, UNESCO.
- Zhang, D., Finckenberg-Broman, P., Hoang, T., et al(2023). Right to be forgotten in the era of large language models: Implications, challenges, and solutions [DB/OL]. arXiv: 2307.03941v3 [cs.CY]22 Sep 2023.
- 中共中央、国务院(2022). 关于构建数据基础制度更好发挥数据要素作用的意见 [EB/OL].[2023-10-23]. https://www.gov.cn/zhengce/2022-12/19/content_5732695.htm.
Métadonnées originales de la revue en anglais (archive)
Generative AI and its Uses in Education: Foundational Controversies and Responding Strategies
MIAO Fengchun 1,2
1. National Engineering Laboratory for Cyberlearning and Intelligent Technology, Faculty of Education, Beijing Normal University,
2. Headquarters of UNESCO
Abstract: The paper is the second edition of a serials of interpretative articles on the Guidance on generative AI in education and research released by UNESCO, and the main aim of this edition is to examine the controversies around generative AI and its use in education. Based on an analysis of how it works, the development and deployment of generative AI have triggered the following controversies: worsening digital poverties, outpacing domestic governance, the collection of pre-training data without consent, the unexplainability of the architecture, the foundational models can't under the real world, the outputs of generative AI is polluting the internet, the outputs are projecting dominant values, amplifying the creation and dissemination of illegal deepfakes. Generative AI poses direct and most profound threats on the core values of education including inclusion, equity, cultural and linguistic diversities, pluralism in knowledge construction and expression, and therefore, those core values should be upheld as the logic base when examining the proportionality of generative AI to service purposes of education. Policy-makers and practitioners should follow the logic roadmap of "prioritizing regulation, ensuring inclusion, and guiding applications" to enhance the system-wide governance regulations in order to ensure trustable, self-automatic, and locally relevant eco-systems of generative AI for education, followed by developing capacities and guidance to steer proper uses of generative AI in education.
Keywords: generative AI;content processing across symbolic representations of human thinking;sources of pre-training datasets;equity, inclusion, cultural and linguistic diversities
Notes éditoriales et sources de vérification
- Dates de publication : la revue indique février 2024, volume 30, numéro 1, pages 4–15, DOI 10.13966/j.cnki.kfjyyj.2024.01.001. La date d’archive originale du site, le 27 janvier 2024, est conservée séparément. Article original; DOI; Numéro de la revue
- Noms techniques : ChatGPT, lancé le 30 novembre 2022, utilisait initialement la série GPT-3.5. Un jeton n’équivaut pas nécessairement à un octet. Stanford a développé Alpaca par ajustement fin de LLaMA 7B de Meta ; l’original attribuait à tort Alpaca à Meta. Ces noms sont corrigés. Lancement de ChatGPT; Alpaca de Stanford
- Échelle des modèles et données d’entraînement : l’affirmation originale de « 1 800 milliards » de paramètres pour GPT-4 n’a pas été confirmée par le rapport technique officiel, qui n’a pas révélé la taille du modèle. Les estimations du corpus de GPT-3, les proportions des sources et des langues et les chiffres de calcul de 2012–2019 restent des données historiques attribuées, et non des descriptions du ChatGPT initial ou de modèles ultérieurs. Rapport technique de GPT-4
- Réglementation historique : le 9 décembre 2023 a abouti à un accord politique provisoire dans l’UE ; le règlement formel sur l’IA est une législation de 2024. Le titre complet du texte chinois est Mesures provisoires pour la gestion des services d’intelligence artificielle générative, annoncées le 13 juillet 2023 et applicables à partir du 15 août. Les propositions de révision et les comparaisons avec le décret américain restent des analyses historiques. Accord européen de 2023; Règlement européen sur l’IA de 2024; Texte original de la CAC
- Âge et signalement : treize et seize ans sont des recommandations discutées dans le texte, et non des âges légaux universels pour converser avec une IA. L’article 8 du RGPD concerne le consentement des enfants au traitement des données dans certaines conditions. La dernière mention des « adultes » du paragraphe original est corrigée en « mineurs ». Les obligations de signalement ou de transparence de l’article 12 des Mesures chinoises et de l’article 50 du règlement européen sur l’IA de 2024 doivent être distinguées des règles de protection des données du RGPD. RGPD; Texte original de la CAC; Règlement européen sur l’IA de 2024
- Désapprentissage : l’affirmation originale d’impossibilité est trop absolue. La version citée de Zhang et ses collègues, datée du 22 septembre 2023, traite de confidentialité différentielle, de désapprentissage automatique, d’édition de modèles et d’ingénierie des instructions. Le problème de la suppression de l’influence des données est conservé, avec ces approches techniques et leurs difficultés de mise en œuvre. Étude citée de 2023
- Taux d’hallucination : les pourcentages cités concernent la tâche historique de fidélité des résumés de Vectara. La version du 1er novembre 2023 utilisait 831 documents résumés par tous les modèles comparés. Il ne s’agit pas de taux d’erreur pour des questions générales et ils n’établissent pas de taux d’erreur en chinois. Une révision historique fixe est liée plutôt que le classement actuel évolutif. Classement historique de Vectara
- Statistiques d’hypertrucages : le rapport sectoriel cité analysait 95 820 vidéos et décrivait une hausse de 550 % depuis 2019. La mention originale de « près d’un million de nouvelles vidéos » contredit cette source ; « 5,5 fois » ne doit pas être assimilé à un pourcentage de croissance. Les résultats de 98 % et 99 % restent attribués à l’enquête du rapport et ne sont pas présentés comme un recensement mondial ou des chiffres actuels. Rapport sur les hypertrucages de 2023
- Handicap et autorisation : l’original regroupait globalement les mineurs et les personnes handicapées comme dépourvus de pleine « capacité pénale », ce qui ne constitue pas une règle générale valable d’autorisation. Cette édition distingue la tutelle applicable, l’information adaptée à l’âge, l’accessibilité, l’aide à la décision et le consentement valable. L’article 12 de la Convention relative aux droits des personnes handicapées reconnaît l’égalité de capacité juridique ainsi que les soutiens et garanties nécessaires à son exercice. Convention relative aux droits des personnes handicapées
- Cadres et jugements de recherche : les tableaux 2 et 3 conservent les projets en cours d’élaboration lors de la rédaction ; les cadres ultérieurs de 2024 sont présentés séparément. Les affirmations sur la compréhension, les connaissances, le droit d’auteur et la créativité sont les arguments de l’auteur à l’époque. Les statistiques et résultats comparatifs relèvent du périmètre des études originales. Article original
Source : Miao, Fengchun (2024), Generative AI and its Uses in Education: Foundational Controversies and Responding Strategies, Open Education Research, 30(1), 4–15. Les affiliations et les métadonnées originales en anglais sont conservées à partir de l’archive. Les droits correspondants restent à la revue et aux auteurs.
Recherches et ressources associées
Pour poursuivre : guide de l’UNESCO sur l’IA générative ; premier article sur la pertinence éducative ; actualité sur les cadres de compétences en IA de 2024 pour les enseignants et les élèves ; ressources d’éducation spécialisée et inclusive.
Lien original: https://aiedchair.bnu.edu.cn/news-6398-fr/