نُشرت مقالة فنغ تشون مياو في Open Education Research، المجلد 30، العدد 1 لعام 2024، بوصفها التفسير الثاني لدليل اليونسكو بشأن الذكاء الاصطناعي التوليدي في التعليم والبحث. وتحافظ هذه الطبعة على نطاق النص الأصلي كاملاً، بما يشمل ثلاثة أشكال وسبعة وعشرين مرجعاً والبيانات الأصلية باللغة الإنجليزية، مع أقسام منظمة وجداول نصية ميسّرة الوصول. وتُقرأ الأحكام التقنية والإحصاءات وتحليلات السياسات في سياق كتابتها عام 2023؛ وتوثّق الملاحظات التحريرية تصحيحات الأسماء والأرقام والأوصاف القانونية.
فنغ تشون مياو — الانتسابان المؤسسيان 1 و2
1. المركز الوطني للبحوث الهندسية في التعلّم عبر الشبكات والتكنولوجيا الذكية، جامعة بكين للمعلمين.
2. مقر اليونسكو.
الملخص: هذه هي المقالة الثانية في سلسلة تفسّر دليل اليونسكو بشأن الذكاء الاصطناعي التوليدي في التعليم والبحث. وتبحث الخلافات الأساسية الناشئة عن الذكاء الاصطناعي التوليدي وتطبيقاته التعليمية. ويكشف تحليل القيود التقنية عبر مراحل عمله عن مشكلات تتعلق بتفاقم فقر البيانات، والغموض التكنولوجي وثغرات الحوكمة الوطنية، وجمع بيانات التدريب دون إذن، وصعوبة تفسير بُنى النماذج، وفهم النماذج التأسيسية للعالم الحقيقي، وتلوّث الإنترنت بالمحتوى المولّد، وإسقاط القيم المهيمنة، وانتشار التزييف العميق غير المشروع. وترى المقالة أن الذكاء الاصطناعي التوليدي قد يؤثر بعمق في قيم تعليمية تشمل المساواة والشمول، وفاعلية المتعلّمين، وتنوّع القيم واللغات والثقافات، والتعددية في بناء المعرفة. وينبغي أن تكون هذه القيم نقطة الانطلاق لتقييم ملاءمته التعليمية.
وعلى صانعي السياسات والممارسين اتباع مسار «إعطاء الأولوية للتنظيم، وضمان الشمول، وتوجيه التطبيقات»، وتعزيز التنظيم وإنفاذه على مستوى المنظومة لإنشاء منظومات تعليمية للذكاء الاصطناعي التوليدي آمنة وجديرة بالثقة وقابلة للتحكّم المستقل وملائمة للسياق المحلي. وينبغي أن يدعم بناء القدرات والإرشاد العملي بعد ذلك الاستخدام التعليمي المناسب.
الكلمات المفتاحية: الذكاء الاصطناعي التوليدي؛ معالجة المحتوى؛ مصادر مجموعات بيانات التدريب؛ الإنصاف والشمول والتنوّع اللغوي والثقافي.
مقدمة
في نوفمبر 2022، أطلقت OpenAI برنامج ChatGPT، فاتحة مرحلة جديدة في انتقال الذكاء الاصطناعي التوليدي من البحث إلى الاستخدام التجاري والعام. واستند ChatGPT الأول إلى سلسلة GPT-3.5؛ وقد صُحّحت هنا تسمية «ChatGPT-3» الواردة في الأصل بالرجوع إلى معلومات الإطلاق لدى المطوّر، وفق ما توضحه الملاحظات التحريرية. وتجمع المقالة التأثيرات والاستجابات التنظيمية خلال السنة الأولى تقريباً بعد الإطلاق في أربعة مجالات.
1. الاحتكار والتنوّع. تصف المقالة OpenAI وGoogle وMeta بأنها أسست مواقع هيمنة رأسية تمتد من النماذج التأسيسية والبنية التحتية للشبكات إلى معالجة النصوص والصور والصوت والفيديو. وكانت شركات كبرى أخرى ومجتمعات النماذج المفتوحة تسعى إلى نماذج تأسيسية مفتوحة، وخيارات أوسع من المنصات، ومزيد من التنوّع اللغوي والثقافي عبر التنافس في البحث وتطوير المنظومات.
2. التطبيق والإحلال. كان الذكاء الاصطناعي التوليدي ينتشر بسرعة في الأنشطة التجارية، ويسرّع أتمتة الوظائف في القطاعات المتأثرة.
3. الخلاف والحوكمة. كانت المخاوف المتعلقة بالسلامة والأخلاق تنتقل من الهواجس النظرية إلى قضايا قانونية فعلية. وقابلت الثقة في الإمكانات التحويلية مخاوف بشأن العواقب الإنسانية، مما سرّع إجراءات تشريعية موجّهة في بلدان وولايات قضائية منها الصين والولايات المتحدة والاتحاد الأوروبي.
4. الرؤية والواقع. كان الظهور السريع للذكاء الاصطناعي التوليدي يُحدث اضطراباً وتغييراً في التعليم وخدمات اجتماعية أخرى، بينما بقيت فجوة كبيرة بين تلك التطورات والتقييمات المتأنية للملاءمة التعليمية والفائدة العملية للطلاب محلياً، وخصوصاً القاصرين. وظلت الآراء العامة منقسمة إزاء عواقبه المحتملة على السلامة والأخلاق.
تتبّع دليل اليونسكو بشأن الذكاء الاصطناعي التوليدي في التعليم والبحث، الصادر في سبتمبر 2023 والمشار إليه فيما يلي بالدليل (Miao، 2023)، مبادئ عمل التكنولوجيا وحدد بصورة منهجية ثمانية خلافات أساسية. وبحث آثارها على الاستخدام التعليمي، واقترح استجابات للحوكمة العامة وسياسات تعليمية وإطاراً عملياً للتفاعل بين الإنسان والآلة ملائماً للأشخاص المعنيين.
باعتبار هذه الدراسة التفسير الثاني للدليل، فإنها تبحث بصورة منهجية الخلافات المحيطة بالذكاء الاصطناعي التوليدي والتعليم، وتحدد استجابات الحوكمة والتوصيات العملية بحسب الأسباب والجهات المسؤولة. ويستند تفسيرها إلى ثلاثة افتراضات مترابطة:
أولاً، ينبغي ألا يشكّل الابتكار في الذكاء الاصطناعي، والسلامة والموثوقية، والتطبيق الاجتماعي الشامل والمتساوي معضلة ثلاثية. بل ينبغي أن تتقدم هذه الأهداف الثلاثة معاً وأن يعزز بعضها بعضاً.
ثانياً، ترى الدراسة أن التهديدات الأكثر مباشرة وعمقاً تمسّ المساواة والشمول في التعليم، وفاعلية المتعلّمين، وتنوّع القيم واللغات والثقافات، والتعددية في بناء المعرفة. ولذلك ينبغي أن تكون هذه القيم الأساسية نقطة الانطلاق لفحص الملاءمة التعليمية للذكاء الاصطناعي التوليدي.
ثالثاً، ينبغي أن تتبع التطبيقات التعليمية منطق «إعطاء الأولوية للتنظيم، وضمان الشمول، وتوجيه التطبيقات».
أولاً: الجذور التقنية للخلافات
يجب أن تستند مناقشة الخلافات المتعلقة بالذكاء الاصطناعي التوليدي في التعليم إلى كيفية عمل التكنولوجيا وحدودها وآثارها الاجتماعية المرصودة والمحتملة.
1. مبادئ العمل ومصادر بيانات التدريب وتوزيع اللغات
يعرّف الدليل الذكاء الاصطناعي التوليدي من خلال محاكاة الذكاء الاصطناعي للأنظمة الرمزية التي تُمثَّل بها الأفكار البشرية: فهو ينتج المحتوى تلقائياً استجابة لتعليمات تُصاغ بتلك الأنظمة. وكانت قدراته في التعرّف على الأنماط وإنتاج المحتوى تتعزز في النصوص والكلام والأصوات والصور والفيديو والشيفرة الحاسوبية. ووفق عرض المقالة، يستخدم توليد النص شبكات عصبية اصطناعية ونماذج قائمة على بنية المحوّل Transformer، تُسمّى عادة النماذج اللغوية الكبيرة: وهي أنظمة تعلّم عميق تتدرب على معلومات جُمعت من صفحات الويب ومحادثات وسائل التواصل الاجتماعي ووسائط أخرى على الإنترنت. وتتعلّم النماذج التوليدية المدرّبة مسبقاً للنص أو الكلام أنماطاً نحوية ضمن مجموعات التدريب، وتكتسب القدرة على الاستجابة للتعليمات من خلال تطبيق الأنماط المتعلَّمة مراراً في دورات التدريب والاختبار والتحسين. والمراحل الأساسية هي:
1. تقسيم التعليمة إلى وحدات ترميز، أو tokens، يمكن للذكاء الاصطناعي معالجتها، وتمريرها إلى محوّل توليدي مدرّب مسبقاً. ويُستخدم هنا مصطلح «وحدة ترميز» بدلاً من «بايت»، وهو المصطلح غير الدقيق في النص الصيني الأصلي.
2. التنبؤ باحتمال ظهور كلمات أو عبارات معيّنة في السياق انطلاقاً من الأنماط اللغوية المحددة في بيانات التدريب. وتجمع التنبؤات الإحصائية الكلمات والعلاقات النحوية في استجابات مترابطة، وتتوقع الكلمات أو العبارات الأرجح أن تأتي تالياً.
3. تحويل الكلمات أو العبارات المتوقعة إلى نص قابل للقراءة أو كلام مفهوم. وتصفّي ضوابط الحماية المخرجات التي يتضح أنها غير مشروعة أو غير مناسبة، بينما تحسّن معالجة إضافية النحو وقابلية الفهم لتقريبهما من التعبير البشري. وتتكرر العملية إلى أن تُنتج استجابة كاملة.
تشرح المقالة توليد الصور والموسيقى أساساً من خلال الشبكات التوليدية التنافسية GAN، التي يمكن دمجها مع المشفّرات التلقائية التغايرية. وتذكر أيضاً نماذج الانتشار بوصفها مساراً توليدياً آخر للصور. وتتألف الشبكة التوليدية التنافسية من مكوّنين متنافسين: المولّد والمميّز. واستجابة لتعليمة، يحدد المولّد توليفات من العناصر البصرية أو الموسيقية وينتج صورة أو مقطعاً موسيقياً أولياً. ويقارنه المميّز بأمثلة حقيقية. ثم يعدّل المولّد معلماته بناء على المقارنة. ويجعل التدريب المتكرر عبر تكرارات كثيرة الصور أو الموسيقى المولّدة أقرب إلى الواقع.
تعتمد قدرات المحوّل التوليدي المدرّب مسبقاً على بنيته وطرائق تدريبه وجودة بيانات ما قبل التدريب وكميتها ومعلمات النموذج. والمعلمات قيم عددية تحدد كيفية معالجة الشبكات العصبية للمدخلات وإنتاج المخرجات، وتشفّر السمات المكتسبة أثناء التدريب. ويؤثر تعريفها وحجمها في الأداء. واستخدم GPT-3 نحو 175 مليار معلمة. وتكرر المقالة الأصلية ادعاء غير مؤكد بأن GPT-4 يضم «1.8 تريليون»؛ غير أن التقرير التقني الرسمي لـGPT-4 لم يفصح عن حجم النموذج، كما توضح الملاحظات التحريرية. وشملت خريطة النماذج آنذاك منتجات ChatGPT من OpenAI؛ وAlpaca الذي طوّرته جامعة ستانفورد بالضبط الدقيق لنموذج LLaMA من Meta؛ ونماذج Llama من Meta؛ وBard من Google الذي كان يستند حينها إلى PaLM 2؛ وGemini متعدد الوسائط. وتضمنت مصادر التدريب صفحات ويب مجمّعة بالزحف، ومحادثات وسائل التواصل، وكتب مكتبات إلكترونية، ومحتوى موسوعياً.
وبالنسبة إلى GPT-3، تستشهد المقالة بتقدير لمدوّنة تبلغ نحو 1 تيرابايت (Thompson، 2023)، تتألف تقريباً من 61.75% مواد Common Crawl التي جُمعت من الإنترنت منذ 2012؛ و18.86% منشورات ونقاشات Reddit التي حصلت على أكثر من ثلاثة أصوات إيجابية؛ و15.9% كتب من Library Genesis وSmashwords؛ و3.49% من ويكيبيديا. وهذه تقديرات تاريخية لمصادر المقالة وليست وصفاً لـChatGPT الحالي. وتبرز المقالة هيمنة لغات الولايات المتحدة وأوروبا في النماذج التي كانت سائدة: ففي مدوّنة GPT-3 المذكورة بلغت الإنجليزية نحو 92.65%، واللغات الأوروبية الأخرى أكثر من 5%، والصينية أقل من 0.1%. وفي Llama 2 من Meta بلغت الإنجليزية 89.7% والصينية 0.13%، مع تغير طفيف في اللغات الخمس عشرة الأخرى المتصدرة (Touvron وآخرون، 2023). كما استلزم النمو السريع للبيانات والمعلمات مزيداً من الحوسبة عالية الأداء.
وبالنسبة إلى الفترة 2012–2019، تورد المقالة أن القدرة الحاسوبية المستخدمة لتدريب نماذج الذكاء الاصطناعي الرئيسية كانت تتضاعف كل ثلاثة إلى أربعة أشهر (جامعة ستانفورد، 2019).
2. التقدم المتكامل في معالجة المحتوى والحدود المحتملة لهذه الفئة التقنية
تصف الدراسة تقدماً متكاملاً في التقنيات الأساسية والمساندة: الجمع بين طرائق التعلّم العميق، وتحسين البُنى، وصقل مجموعات معلمات على مقياس مئات المليارات، والتراكم الديناميكي لبيانات التدريب عبر المنصات، ونمو القدرة الحاسوبية لمعالجة مجموعات هائلة من البيانات. وقد تؤدي هذه التطورات معاً إلى «تأثير تسارع منفلت». أولاً، يوسّع التقدم في معالجة المعلومات وعرضها عبر الأنظمة الرمزية القدرات التقنية، ويسرّع العمل على رقائق الذكاء الاصطناعي والحوسبة الفائقة ونماذج معالجة البيانات. وتفسر الطبيعة التأسيسية لهذه التطورات الانتشار الواسع لمصطلح «النماذج التأسيسية» الذي اقترحه باحثون في ستانفورد عام 2021 (Bommasani، 2021). ثانياً، كان الذكاء الاصطناعي التوليدي يدفع إلى تغيير المتصفحات ومحركات البحث والبنية التحتية الرقمية، ويصبح نقطة تحكّم مهمة في الأمن الوطني للبيانات والخصوصية الفردية، ويضغط لتحديث التنظيم وأنظمة الأمن.
ثالثاً، يقدم أدوات إنتاجية للأنشطة الاقتصادية والاجتماعية التي تشمل غاياتها المباشرة أو غير المباشرة إنتاج المحتوى أو توليفه، مع إمكان إحداث تغيرات كبيرة في الإنتاج. لكن المؤلف يرى أن قدرته على تحسين الكفاءة وتحويل قطاعات كالتعليم، التي تتجاوز غاياتها إنتاج المحتوى، قد تكون محدودة بدرجة كبيرة.
عند فحص المسارات التقنية المعروفة آنذاك، يصف المؤلف إنجازات الشبكات العصبية بأنها ملاءمة إحصائية للمنحنيات، تختلف عن الاستدلال البشري الذي يجمع العلاقات الزمنية والمكانية والسببية (Pearl وMackenzie، 2018). وإذا كان التعلّم العميق هو المسار الحاسوبي المناسب لحل المشكلات على نحو يشبه البشر، فقد يفضي استمرار التقدم إلى تأثير منفلت يتجاوز معالجة المحتوى: نقطة تفرّد مفترضة يتجاوز عندها الذكاء الاصطناعي ذكاء البشر ويتطور في مسار مستقل نسبياً عن سيطرتهم. لكن المؤلف يرى أن المبادئ المعروفة حينها للنماذج التأسيسية بدت محصورة في توليف المحتوى والمعالجة عبر التمثيلات الرمزية وتحويل الصيغ، بدلاً من أن تشكّل طريقاً تقنياً إلى الفهم البشري. وفي هذا التفسير، فإنها تخاطر بارتكاب «خطأ في الفئة» (Bishop، 2021). وظل السؤال مفتوحاً عما إذا كانت التطورات المرصودة تمثل قفزة في الأداء تسبق عنق زجاجة من هذا النوع.
ثانياً: الخلافات الأساسية حول الذكاء الاصطناعي التوليدي
تفهم المقالة هذه الخلافات باعتبارها مخاوف إنسانية ناشئة عن التفاعل بين الإنسان والآلة، وتدرسها من بُعدين تقني وإنساني. ويتتبّع البعد التقني دورة حياة أنظمة الذكاء الاصطناعي: إنتاج البيانات وتخزينها؛ والوصول إلى البيانات ومعدات معالجتها والسيطرة عليها؛ والآثار المرصودة للتنبؤات والقرارات القائمة على البيانات والخوارزميات؛ والذكاء الاصطناعي المتجسّد، بما فيه الواجهات والأجهزة الذكية. ويشمل البعد الإنساني الوجود الفردي والتفاعل الاجتماعي والحوكمة الوطنية والعلاقات بالبيئات والنظم الإيكولوجية. وتتضمن مستوياته المترابطة الأفراد، والجماعات المتفاعلة، والعلاقات المنظمة في صورة دول ذات سيادة، والتفاعلات بين الناس ومحيطهم (Miao، 2022). وقبل التبنّي واسع النطاق، ينبغي للمستخدمين فحص جمع بيانات التدريب واستخدامها، والبُنى الأساسية والمخرجات القائمة على الأنماط، وتقييم التهديدات المباشرة والتأثيرات المحتملة في الأفراد والمجتمعات والدول.
1. استخراج إنتاجية البيانات: تفاقم فقر البيانات والفقر الرقمي
يرى المؤلف أن آراء عام 2022 بشأن بناء الأنظمة الأساسية للبيانات لتعزيز دورها بوصفها عامل إنتاج، الصادرة في الصين عن اللجنة المركزية للحزب الشيوعي الصيني ومجلس الدولة، تشكّل علامة قانونية على عصر حماية ملكية البيانات والحقوق المرتبطة بها. ومن هذا المنظور، فإن جمع بيانات الأفراد والشركات دون مقابل والربح من نماذج مدرّبة عليها يضعان في الواجهة خلافات كانت أقل ظهوراً بشأن استخراج قيمة البيانات عبر الحدود والقطاعات.
أصبح الوصول إلى البيانات الجيدة وتطبيقها، والإنتاج المستمر لبيانات جيدة عبر الإنترنت أو التحويل، من الشروط المهمة للتنمية الاقتصادية الوطنية والفرص الرقمية للأفراد. وتعاني البلدان التي تفتقر إلى الوصول إلى البيانات أو قدرات استخراجها أو الحوسبة الفائقة، والأفراد الذين لا يستطيعون دفع تكلفة تطبيقات البيانات، «فقر البيانات» (Marwala، 2023). ويرى المؤلف أن تدريب النماذج التأسيسية على بيانات جُمعت مجاناً ثم فرض رسوم على خدماتها قد يفاقم هذا الفقر. ويقوم هذا الإنتاج على ثلاثة متطلبات: الابتكار في بُنى الذكاء الاصطناعي وطرائق تدريبه، ومجموعات بيانات ضخمة جداً، وقدرة حوسبة فائقة. وفي الفترة المدروسة، اعتبر المؤلف أن الولايات المتحدة والصين والاتحاد الأوروبي وعدداً قليلاً من الشركات التقنية العملاقة وحدها كانت تمتلك الشروط الثلاثة معاً. وكانت البلدان الفقيرة بالبيانات تتخلّف أكثر وتُستبعد من البحوث الأساسية في النماذج التأسيسية.
ويسرّع انتشار الاستخدام إنتاج البيانات والتكرار التقني لدى المتصدرين، معززاً دورة الفجوة الرقمية.
لعكس هذه الدورة، ينبغي للبلدان تحديد أوجه الضعف ومعالجتها عبر سلسلة إنتاج البيانات. وتشمل «تصنيفات أسباب فقر البيانات» المقترحة تغطية الإنترنت، ومحو الأمية الرقمية لجميع السكان، وحركة البيانات الميسورة التكلفة، والمواهب في الذكاء الاصطناعي وحوافز الابتكار، والوصول إلى رقائق ذكاء اصطناعي وحوسبة فائقة مؤهلة، والقدرة على تدريب نماذج محلية ببيانات وطنية أو دولية موثوقة. وثمة سؤال آخر: هل ينبغي لتدابير دولية، مثل ضريبة استخدام البيانات، أن تعيد توزيع القيمة الفائضة عندما يجمع مقدمو الخدمات عبر الحدود بيانات كثيرة من البلدان المنخفضة الدخل؟ إن تعريف الحجم المستخدم وتتبّعه، وحساب القيمة الفائضة والمعايير الضريبية، والموازنة بين الابتكار والمصالح الأساسية للسكان الفقراء بالبيانات، تظل قضايا حدودية صعبة في الحوكمة الدولية للبيانات.
2. الحوكمة في الولايات القضائية المتلقية للخدمة: فقدان السيطرة الوطنية
ينبغي أن تخضع خدمات الذكاء الاصطناعي التوليدي العابرة للحدود لحوكمة الولايات القضائية التي تخدمها، لكن الغموض التقني يخلق صعوبات. أولاً، قد يحجب مقدمو الخدمات المهيمنون معلومات الشفافية الأساسية عن الهيئات الأكاديمية المستقلة أو يقاومون التقييم الأكاديمي (Bommasani، 2023). ثانياً، يمكن لحماية الملكية الفكرية في دول منشأ المزودين، ولا سيما الولايات المتحدة في هذا العرض، أن تقيد وصول الدول المستخدمة إلى التقنيات الأساسية وتُعقّد فحص الأنظمة والتطبيقات (Lin، 2023). ثالثاً، رغم الدعوات إلى وقف مؤقت للتطوير ومواءمته مع الحوكمة العامة، تتحرك دورات التطوير المدفوعة برأس المال أسرع بكثير من صياغة اللوائح، مما يضع السلطات في وضع تقني أضعف بكثير عند معالجة المخاوف القانونية والأخلاقية.
تصف المقالة مستويات متعددة من الغياب المؤسسي أو التأخر. أولاً، تفيد بأن 137 بلداً كانت لديها أطر لخصوصية البيانات بحلول يوليو 2023، مما يترك نحو ثلث الدول دون قوانين أساسية لحماية الخصوصية (الأونكتاد، 2023). ثانياً، كان نحو 67 بلداً يمتلك استراتيجيات وطنية للذكاء الاصطناعي قبل الدليل؛ وأعلنت رواندا وجمهورية الدومينيكان استراتيجيتيهما بعده. ثالثاً، تذكر أن نحو 40 بلداً فقط كانت لديها سياسات لأخلاقيات الذكاء الاصطناعي بحلول يوليو 2023. رابعاً، يحدد المؤلف الصين والولايات المتحدة والاتحاد الأوروبي بوصفها الجهات التي كانت قد بحثت حماية الملكية الفكرية للأعمال الاصطناعية وأصدرت مواقف واضحة بشأن إدارتها. وكانت الصين قد نشرت التدابير المؤقتة لإدارة خدمات الذكاء الاصطناعي التوليدي قبل الدليل. وأصدرت الولايات المتحدة أمرها التنفيذي بشأن الذكاء الاصطناعي الآمن والجدير بالثقة في أواخر أكتوبر 2023 (The White House، 2023).
وفي 9 ديسمبر 2023، توصل مفاوضو البرلمان الأوروبي والمجلس إلى اتفاق سياسي مؤقت بشأن قانون الذكاء الاصطناعي. أما القانون الرسمي فينتمي إلى عام 2024؛ فلا ينبغي فهم تعبير «الإقرار» في ديسمبر 2023 الوارد في الأصل على أنه اعتماد رسمي ودخول في النفاذ آنذاك، كما توضح الملاحظات التحريرية.
3. حقوق النشر في بيانات ما قبل التدريب: استخدام المحتوى دون إذن
يثير جمع مجموعات بيانات التدريب واستخدامها خلافات كبيرة بشأن الإذن باستخدام بيانات الأفراد والمنظمات والمحتوى المحمي بحقوق النشر.
تُدرَّب النماذج على النصوص والأصوات والشيفرة والصور ومواد أخرى تُجمع من الإنترنت بالزحف. وترى المقالة أن النماذج الرئيسية جمعت هذه المواد كثيراً دون إذن مسبق، مما أنشأ نزاعات ودعاوى ملكية فكرية، بما فيها مزاعم بموجب تشريعات حماية البيانات مثل اللائحة العامة لحماية البيانات GDPR (الاتحاد الأوروبي، 2016). وتبرز قطاع الأخبار: ففي أواخر أكتوبر 2023، زعمت News/Media Alliance الأمريكية، الممثلة لأكثر من 2200 ناشر أخبار، أن ChatGPT استخدم ملايين المقالات والتقارير الصحفية المدفوعة في التدريب دون إذن أصحاب الحقوق، وسعت بوسائل قانونية إلى حذف محتوى من Common Crawl قيل إنه جُمع على نحو غير مشروع (Robertson، 2023). وتثير هذه الممارسات أيضاً الحق في المحو الذي يتيح لأصحاب البيانات طلب حذف بيانات جُمعت دون إذن. وبعد أن تؤثر البيانات الشخصية في نموذج مدرّب، يرى المؤلف صعوبة كبيرة في إزالة تأثيرها.
ويستعمل الأصل تعبيرات مطلقة مثل «لا إمكانية لعدم التعلّم» و«مستحيل»؛ وهنا قُيّدت بوصفها جزءاً من حجة ذلك الوقت. وتناقش الدراسة المستشهد بها محو التعلّم الآلي وتحرير النماذج ومسارات أخرى، كما توضح الملاحظات التحريرية. وتشمل المشكلة إزالة استجابات متعلَّمة تعكس آراء صاحب البيانات وخصائصه اللغوية أو الثقافية (Zhang، 2023).
4. قابلية تفسير البنية: مخرجات نماذج غامضة
تصف المقالة بُنى الشبكات العصبية بأنها صناديق سوداء يصعب تفسير ترتيب عقدها وطبقاتها وتعريف معلماتها وحساباتها. وتفاقم التطورات الحديثة هذه المخاوف. وحتى إن أمكن تفسير النهج العام، بما فيه الخوارزميات، جزئياً، يصعب تفسير معلمات محددة ومساهمتها النسبية في مخرج بعينه. وتستخدم النماذج التأسيسية الكبيرة مجموعات واسعة من المعلمات والأوزان للتعرّف على الأنماط وإنتاج الاستجابات، مما يصعّب شرح سبب توليد نموذج محدد لإجابة معينة. ويتوقع المؤلف أن يزيد الحجم وتعقيد البنية من حدة المشكلة.
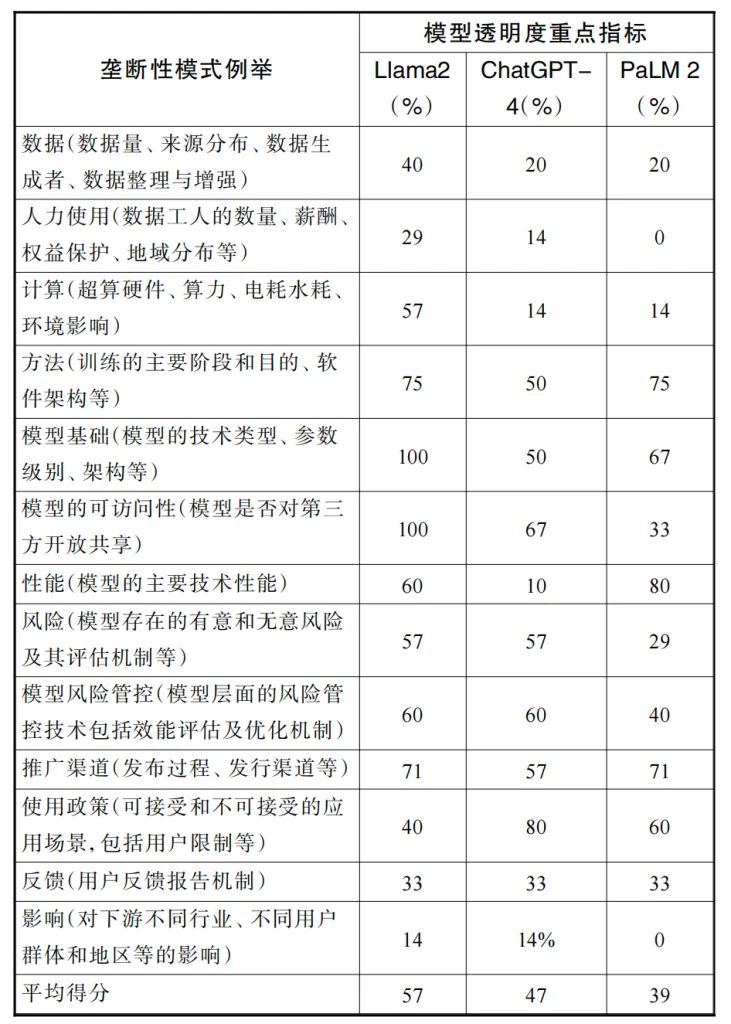
تتفاعل القيود التقنية على قابلية التفسير مع إحجام المزودين عن كشف المعلومات ذات الصلة، فتعرقل المنظّمين والباحثين المستقلين في تقييم المخاطر المتعمدة والأضرار غير المقصودة. ويقيّم مؤشر شفافية النماذج التأسيسية في ستانفورد (Bommasani، 2023) عناصر تقنية مهمة في النماذج الرئيسية. وتشير المقالة إلى مقارنة شملت نحو عشرة نماذج كبرى، وتعيد عرض مؤشرات مختارة لثلاثة أمثلة بارزة في الجدول 1. وحجتها أن النماذج الغامضة والمخاطر التي يصعب كشفها تجعل تتبّع الأخطاء صعباً، وتحد من التقييم والوقاية الشفافين. وتورد توصيات خبراء بعدم استخدام الذكاء الاصطناعي التوليدي في المهام عالية المخاطر.
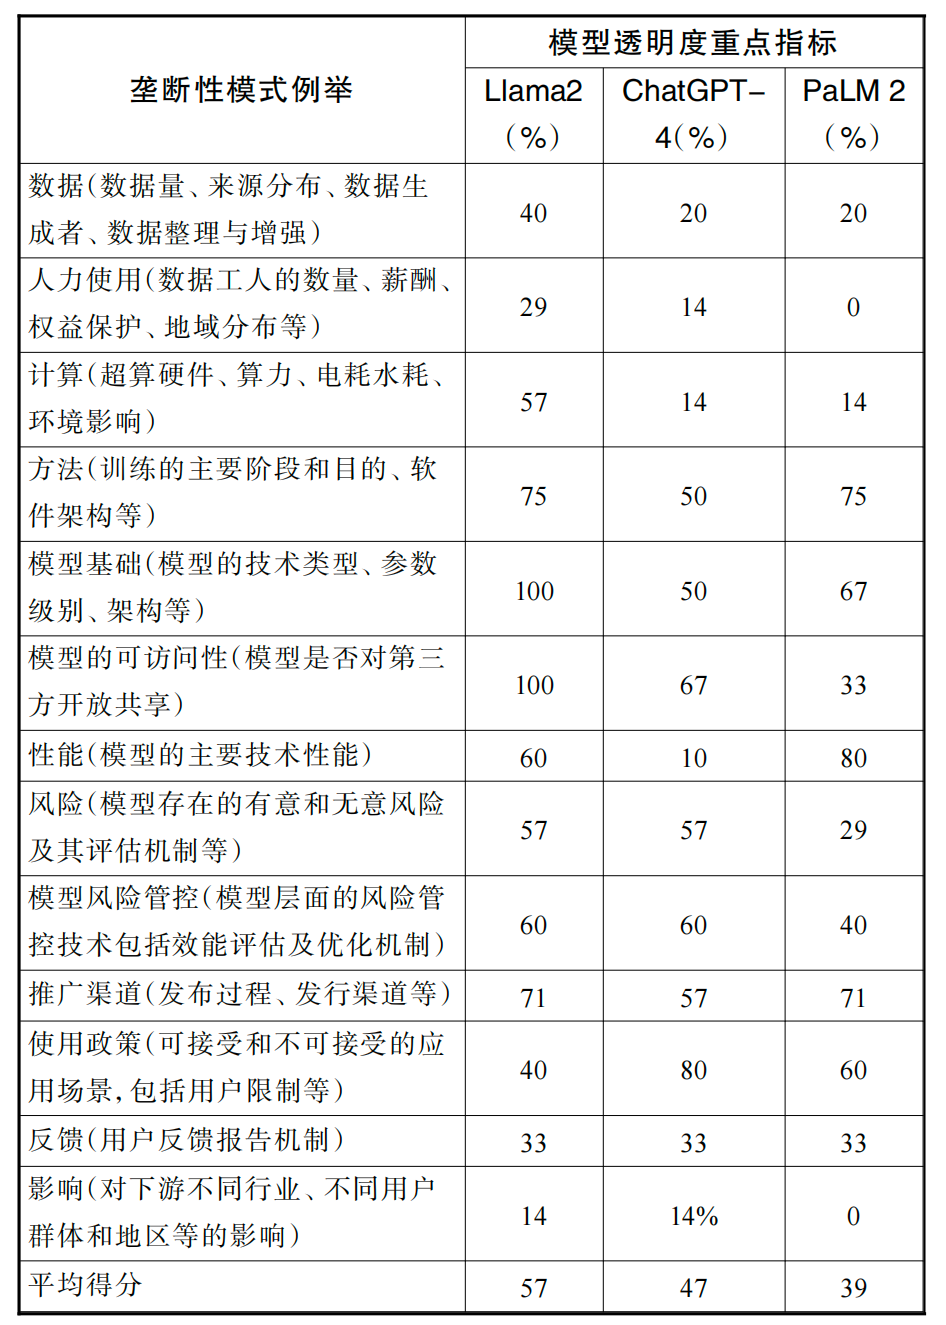
| المؤشر | Llama 2 | ChatGPT-4 — تسمية المجلة | PaLM 2 |
|---|---|---|---|
| البيانات: الحجم وتوزيع المصادر والمنتجون والانتقاء والتعزيز | 40 | 20 | 20 |
| العمل: أعداد العاملين على البيانات وأجورهم وحقوقهم وتوزيعهم الجغرافي | 29 | 14 | 0 |
| الحوسبة: العتاد والقدرة والكهرباء والمياه والآثار البيئية | 57 | 14 | 14 |
| الطرائق: مراحل التدريب الأساسية وأغراضها وبنية البرمجيات | 75 | 50 | 75 |
| أساسيات النموذج: التقنيات وحجم المعلمات والبنية | 100 | 50 | 67 |
| إتاحة النموذج: التوافر والمشاركة مع أطراف ثالثة | 100 | 67 | 33 |
| الأداء: القدرات التقنية الرئيسية | 60 | 10 | 80 |
| المخاطر: المخاطر المقصودة وغير المقصودة وآليات التقييم | 57 | 57 | 29 |
| الحد من مخاطر النموذج: التقييم والتحسين | 60 | 60 | 40 |
| التوزيع: عملية الإصدار والقنوات | 71 | 57 | 71 |
| سياسات الاستخدام: الاستخدامات المسموحة والمحظورة والقيود على المستخدمين | 40 | 80 | 60 |
| التغذية الراجعة: آليات إبلاغ المستخدمين | 33 | 33 | 33 |
| الأثر: القطاعات اللاحقة والفئات والمناطق | 14 | 14 | 0 |
| المتوسط كما ورد في الأصل | 57 | 47 | 39 |
5. الفهم: الدلالة والعالم الحقيقي
يتعرّف الذكاء الاصطناعي التوليدي على الأنماط السياقية احتمالياً وينتج نصاً وفق تركيب لغوي متعلَّم. ويربط المؤلف قصور الفهم الدلالي بالهلوسات التي تتضمن أخطاء واقعية وتاريخية وعلمية. وأوردت قائمة تاريخية لـVectara مستضافة على GitHub، كان آخر تحديث لها في 1 نوفمبر 2023، معدلات هلوسة خاصة بمهمتها بلغت 3%–3.5% لنماذج GPT، و5.1%–5.9% لنماذج Llama، و12.1% لـGoogle PaLM. وتخص هذه الأرقام أمانة تلخيص المستندات، لا دقة الإجابات عن الأسئلة العامة. وتفترض المقالة كذلك أن معدلات الخطأ في الصينية ولغات أخرى ستكون أعلى، لكن تلك القائمة لا تثبت مقارنة بين اللغات. ومن ثم قد يتعلم الطلاب الذين يفتقرون إلى أساس معرفي متين من محتوى غير يقيني أثناء المحادثات المستقلة. ويرى المؤلف أنه لا ينبغي التعامل مع هذه الأنظمة بوصفها مصادر موثوقة للمحتوى التدريسي.
ويميّز أيضاً بين معالجة الأنماط النحوية وفهم أشياء العالم الحقيقي وعلاقاتها، والعلاقات الإنسانية والاجتماعية، وعلاقات الناس بالأشياء والتقنيات. ويشير إلى أن الاكتشاف العلمي يعتمد على مراقبة العالم والتجريب والاستدلال، بينما يولّف الذكاء الاصطناعي التوليدي الأدبيات السابقة أساساً. وفي عرضه، تتطلب المعرفة الجديدة فاعلية إنسانية تستخدم الذكاء الاصطناعي أداة مساعدة. ويستنتج الأصل أيضاً حكماً بشأن «المعرفة» من نقاشات حقوق النشر؛ ولا ينبغي الخلط بين الحماية بحقوق النشر وتعريف المعرفة. وبالاستناد إلى Candelon (2023)، تتساءل المقالة أيضاً عن قدرة النماذج على تقديم حلول موجّهة ومبتكرة لتحديات واقعية معقدة أو إصدار أحكام قيمية اجتماعية. وتخلص إلى أنه لا ينبغي لها أن توجّه بصورة مستقلة تعلّم المعرفة المعقدة أو حل المشكلات غير المحكَمة البنية دون معلمين بشريين.
يرى المؤلف أن هذه القيود تحدّ من التحول التعليمي الإيجابي في المحتوى التأسيسي والتفكير المتقدم وحل المشكلات المعقدة والقيم والتنمية البشرية. وقد يمارس الذكاء الاصطناعي التوليدي تأثيره جزئياً عبر تحدّي نواتج التعلّم والتقييم من الخارج: فأتمتة معالجة المحتوى وصعوبة اكتشاف إسناد العمل إلى الغير تضعفان قيمة التوليف والإنتاج منخفضَي المستوى بوصفهما نواتج محورية. وقد يدفع تراجع حصة تدريبات الإملاء والنحو الأساسية، وتقارير تلخيص الأدبيات، وإنتاج الشرائح، والأعمال الفنية الأولية في التقييم التكويني وقليل العواقب، الأنظمة التعليمية إلى إعادة النظر في أولويات التعلّم وطرائق التقييم.
6. تلوّث المعلومات المولَّدة: المحتوى الاصطناعي على الإنترنت
تحدد المقالة شكلين من التلوّث الناشئ عن إنتاج محتوى الذكاء الاصطناعي التوليدي ونشره.
أولاً، قد تعيد النماذج إنتاج مواد ضارة تعلّمتها من الإنترنت، منها المعلومات المضللة والتمييز وخطاب الكراهية، ثم تنشرها مجدداً عبر الشبكة. وقد يضر هذا التداول المتكرر بمتعلّمين من أعمار مختلفة بطرق يصعب عكسها.
ثانياً، يؤثر امتلاء الإنترنت المتزايد بالمواد الاصطناعية في تدريب النماذج اللاحقة. فالتعلّم العميق الجيد يعتمد على بيانات بشرية متنوعة وأشكال تعبير متعددة تُستخلص منها أنماط مختلفة. وعندما يعاد تداول المحتوى المولّد آلياً على نطاق واسع، قد تتدرب النماذج اللاحقة على مخرجات النماذج السابقة. وفي العملية الموصوفة، تتمثل الأحداث العالية الاحتمال أكثر من اللازم والمنخفضة الاحتمال أقل من اللازم، فتختفي تدريجياً ظاهرة الذيل الإحصائي الطويل التي تساعد على حفظ الدقة والتنوّع. ويمكن أن يعزز فقدانها الأنماط المتعلَّمة سابقاً، منتجاً مخرجات أشد تجانساً تشبه المواد الاصطناعية بدلاً من الواقع، ويزيد الأخطاء وربما يؤدي إلى انهيار النماذج. ويطرح ذلك تحديات إضافية للحصول على بيانات تدريب عالية الجودة من الإنترنت (Lutkevich، 2023).
7. إسقاط القيم: التجانس وقمع التنوّع اللغوي والثقافي
قد يؤدي إسقاط قيم متشابهة عبر المخرجات المولَّدة إلى تهميش الفئات المتضررة رقمياً، والتعددية في بناء المعرفة التعليمية، والتعبير عن وجهات نظر مختلفة.
حين تتكرر سلسلة نصية كثيراً في بيانات التدريب، تزداد احتمالات أن يعيد المحوّل إنتاجها وإنتاج جمل مرتبطة بها. وترى المقالة أن المعتقدات الشائعة ومنظورات وسائل الإعلام المهيمنة في مجموعات البيانات الأمريكية والأوروبية قد تصبح «إجابات معيارية» للنموذج، فتقوّي عبر حلقة تغذية راجعة قيماً وأعرافاً لغوية أو ثقافية تتمتع أصلاً بالنفوذ. ويمكن أن يرسّخ التبنّي غير النقدي دون فحص مصادر بيانات التدريب صوراً نمطية ثقافية. وتستشهد بـOmiye (2023)، الذي وجدت اختباراته المتكررة لـChatGPT/GPT-3.5 وGPT-4 وBard وClaude من Anthropic إجابات متحيزة تعكس صوراً نمطية عنصرية في أسئلة عن سعة الرئة ومعدل الترشيح الكبيبي المقدّر وسماكة الجلد وحجم الدماغ. وهذه أمثلة على تحيزات ضارة في النماذج وليست ادعاءات بيولوجية مثبتة.
وبالمقابل، تترك الفئات المهمشة والفقيرة بالبيانات آثاراً أقل على الإنترنت ويقل تمثيلها في مجموعات التدريب، فلا يُتعرَّف إلى قيمها وممارساتها اللغوية والثقافية على نحو كافٍ. ويرى المؤلف أن النماذج الملائمة محلياً والداعمة للتنوّع مهمة للغات الشعوب الأصلية وثقافاتها وللمصالح المشروعة للفئات المحرومة (Miao، 2023).
قد يضيّق الاعتماد المفرط على الذكاء الاصطناعي التوليدي للحصول على «إجابات معيارية» وحلول مجال الأفكار أيضاً، ويضعف الابتكار المتنوع. وفي دراسة Boston Consulting Group المذكورة، التي شملت أكثر من 750 مشاركاً، أفيد بأن الأفكار المنتَجة بمساعدة GPT-4 أقل تنوعاً بنسبة 41% من الأفكار المنتجة دونه. وكثيراً ما أظهر المشاركون ميلاً محدوداً لزيادة التنوّع بعد تلقّي اقتراحات النموذج. وفي الدراسة نفسها، أعرب 70% عن قلقهم من أن يؤدي الاستخدام الطويل للذكاء الاصطناعي التوليدي للحصول على الإجابات إلى تآكل الإبداع البشري (Candelon، 2023). وتنتمي هذه النتائج إلى سياق تلك الدراسة.
8. التزييف العميق غير المشروع: تسهيل الإنشاء والنشر
يخفض الذكاء الاصطناعي التوليدي حواجز المهارة والتكلفة أمام إنتاج التزييف العميق غير المشروع، ويصعّب كشفه، مما يسهّل إنشاءه وتداوله.
تبحث المقالة كيف يستطيع أشخاص يفتقرون إلى مهارات الصحافة أو الموسيقى أو إنتاج الفيديو استخدام المحتوى الاصطناعي لانتحال شخصيات حقيقية، ونشر الأخبار الكاذبة أو الكراهية، والتشهير بالآخرين، والتلاعب بصور ومقاطع موجودة، أو تحقيق أغراض أخرى غير مشروعة. ويقارن المؤلف بين الفوائد غير اليقينية لحل مشكلات المصلحة العامة وسهولة الوصول إلى أدوات للأغراض الخبيثة. وزعم تقرير State of Deepfakes لعام 2023 المشار إليه (Home Security Heroes، المعروفة الآن باسم Security Hero) إمكان توليد مقطع تزييف عميق جنسي صريح مدته ستون ثانية من صورة واحدة واضحة للوجه، في أقل من خمس وعشرين دقيقة ودون مقابل. وقد حلّل التقرير 95,820 مقطع فيديو ووصف زيادة نسبتها 550% مقارنة بعام 2019؛ وصُححت عبارتا الأصل «نحو مليون مقطع جديد» و«5.5 أضعاف» وفقاً لذلك المصدر. وتخص هذه الأرقام مسح التقرير، وليست تعداداً عالمياً متحققاً منه أو مجموعاً حالياً.
وأفاد بأن 98% من مقاطع التزييف العميق التي شملها المسح كانت إباحية، وأن 99% من الأشخاص المستهدفين في هذه الفئة نساء.
ثالثاً: توصيات التنظيم
لمعالجة هذه الخلافات مع تنمية الإمكانات التعليمية، يقترح الدليل مبادئ محورها الإنسان لتطوير الذكاء الاصطناعي واستخدامه. ويهدف مساره «إعطاء الأولوية للتنظيم، وضمان الشمول، وتوجيه التطبيقات» إلى استخدام أخلاقي وآمن وموثوق ومنصف وشامل وذي معنى.
1. نهج محوره الإنسان لحوكمة الذكاء الاصطناعي وتطبيقه
منذ عام 2019، تدعو اليونسكو إلى البحث والتطبيق في الذكاء الاصطناعي على أساس محورية الإنسان، وهو ما فصّلته وثائق منها التوصية الخاصة بأخلاقيات الذكاء الاصطناعي (المشار إليها باسم UNESCO، 2022)، وتوافق آراء بكين بشأن الذكاء الاصطناعي والتعليم (UNESCO، 2019)، والذكاء الاصطناعي والتعليم: إرشادات لواضعي السياسات (المشار إليها باسم Miao، 2022). ووفق هذا العرض، ينبغي للحوكمة والاستخدام حماية الحقوق الأساسية والكرامة والتنوّع الثقافي، إلى جانب فهم متمحور حول الحياة للعلاقات المنسجمة بين الناس والبيئات والنظم الإيكولوجية. ويجب أن يخدم التطوير الناس ويعزز قدراتهم على التعاون الفعال مع الآلات. وعبر مراحل التصميم والتطوير والاستخدام والتكرار، ينبغي أن تبقى الفاعلية البشرية في المركز، مع الجدارة بالثقة والملاءمة للأشخاص والأغراض وقابلية التفسير والسيطرة البشرية والمساءلة البشرية (Miao، 2022).
2. خريطة طريق لحوكمة الذكاء الاصطناعي التوليدي
يوصي الدليل بحوكمة تعاونية تشمل الحكومة بأكملها، وتحدد حقوق الجهات الفاعلة وصلاحياتها ومسؤولياتها والتزاماتها عبر القطاعات والصناعات.
2.1 التفاوض بشأن صكوك دولية، بما فيها قواعد حماية البيانات عبر الحدود
تُقترح قواعد حماية بيانات معترف بها بصورة متبادلة وآليات حوكمة عابرة للحدود بوصفها شروطاً سابقة لمعالجة الفجوات القضائية. وتقدم اللائحة العامة لحماية البيانات مثالاً على إطار قانوني لحوكمة خدمات البيانات العابرة للحدود.
2.2 وضع استراتيجيات ذكاء اصطناعي تشمل الحكومة كلها وحوكمة أخلاقية مشتركة بين القطاعات
يمكن لاستراتيجية تشمل الحكومة كلها أن تنسق حوكمة الذكاء الاصطناعي عبر القطاعات والإدارات. وينبغي لآليات الحوكمة الأخلاقية توضيح السيادة الوطنية على البيانات؛ وحقوق المؤسسات والأفراد في البيانات والخصوصية؛ والعلاقات القانونية في إنتاج البيانات؛ والمبادئ الأساسية لتطوير الذكاء الاصطناعي واستخدامه؛ وتوزيع القيمة الفائضة من منتجات الذكاء الاصطناعي المبنية على بيانات عامة أو بيانات الآخرين.
2.3 تطوير قواعد تتناول الذكاء الاصطناعي التوليدي تحديداً
نشرت الصين التدابير المؤقتة لإدارة خدمات الذكاء الاصطناعي التوليدي في يوليو 2023. ووصفها المؤلف بأنها أول قواعد رسمية عالمياً للحوكمة القضائية لخدمات الذكاء الاصطناعي التوليدي، وهو حكم مقارن صدر في السياق التاريخي للنص الأصلي. واقترح صقل أحكامها القانونية والأخلاقية باستخدام الدليل والمبادرات الأوروبية والأمريكية المعاصرة له. وكانت النقاط التالية ذات صلة خاصة بالتعليم:
1. تصنيف مخاطر السلامة التقنية والتنظيم بحسب مستوى الخطر. يميّز عرض المقالة لمسودة القانون الأوروبي للذكاء الاصطناعي التي كانت قيد النقاش بين المخاطر غير المقبولة، ومنها تقنيات التلاعب بالقاصرين لإحداث اعتماد، والتعرّف على المشاعر، وبعض تنبؤات الذكاء أو السلوك؛ والمخاطر العالية؛ والمخاطر المحدودة؛ والمخاطر الدنيا. ويصف مناهج تبدأ بحظر التطوير والتسويق، مروراً بالإشراف المكثف والمراجعة والرقابة، وصولاً إلى التنظيم الذاتي للقطاع. وحُدد التعليم مجالاً للتدقيق الوثيق. وهذه هي الفئات التي يناقشها النص التاريخي، وليست بياناً بجميع أحكام القانون الذي اعتُمد لاحقاً.
2. وضع ضمانات عمرية للمحادثات المستقلة مع الذكاء الاصطناعي التوليدي. لأن النماذج الحوارية قد تولّد مواد غير مناسبة للقاصرين، يوصي الدليل بعمر ثلاثة عشر عاماً عتبة دنيا للاستخدام المستقل، مع النظر في عتبة أشد هي ستة عشر عاماً. ومع انتقال الخدمات من المحادثات القائمة على المنصات إلى التطبيقات على الأجهزة الشخصية، قد تزداد صعوبة إشراف المنظّمين والبالغين على الاستخدام المستقل. ويدعو المؤلف إلى تقييم هذه المخاطر وتوضيح مسؤوليات الإشراف على استخدام القاصرين. وقد صُححت الإشارة الأخيرة إلى «البالغين» في الفقرة الأصلية، وفق السياق، إلى «القاصرين». والثالثة عشرة والسادسة عشرة توصيتان موضع نقاش، لا سنّاً قانونية عالمية للمحادثة.
3. توضيح مسؤوليات الجهات الأخرى. تقارن المقالة بين التدابير الصينية التي تركز على المزودين والمسؤوليات المؤسسية الأوسع في الأمر التنفيذي الأمريكي لعام 2023. وتقترح واجبات على المؤسسات التي تشتري أنظمة الذكاء الاصطناعي وتنشرها: التحقق المشترك من قانونية البيانات والأدوات وخدمات المحتوى، والمساعدة في رصد التأثيرات المتغيرة على المستخدمين، خصوصاً الفئات المحرومة. وبعد توضيح المسؤوليات المؤسسية، ينبغي النظر أيضاً في واجبات الأفراد، بما فيها الوعي والمهارات اللازمة للتعرّف إلى التهديدات وحماية النفس، والمعارف والمهارات اللازمة للاستخدام المشروع للأدوات والمواد المولّدة.
4. توضيح تمييز المحتوى المولّد وحقوق نشره واستخداماته المسموحة. تلزم التدابير الصينية المزودين بوسم الصور ومقاطع الفيديو المولّدة وفق قواعد خدمات معلومات الإنترنت الخاصة بالتركيب العميق. وينسب الأصل أيضاً متطلبات وسم محتوى الذكاء الاصطناعي إلى اللائحة العامة لحماية البيانات؛ ويجب التمييز بين قانون حماية البيانات وتشريعات شفافية الذكاء الاصطناعي، كما توضح الملاحظات التحريرية. ويرى المؤلف أن الأطر الثلاثة المعاصرة التي نوقشت لم تحسم جميع مسائل الاستخدام المشروع للمنتجات المولّدة. وشملت القضايا المعلّقة الحد من التزييف العميق غير المشروع؛ وتعريف حقوق المستخدمين الدافعين في المواد المولّدة وحمايتها؛ والتمييز بين توليف الأدبيات بمساعدة الذكاء الاصطناعي ضمن بحث يقوده البشر والغش الذي ينتهك الأخلاق الأكاديمية أو قواعد التدريس.
رابعاً: توصيات السياسات والممارسة للاستخدام التعليمي
يقدم الدليل توصيات مفصلة لتطبيقات تعليمية فعالة. وتبرز المقالة ما يلي:
1. ضمان الشمول والإنصاف والتنوّع اللغوي والثقافي
تترتب على العلاقة بين الذكاء الاصطناعي التوليدي والمبادئ المتمحورة حول الإنسان أربع دلالات. أولاً، يشكل تكافؤ الوصول والفرص شرطاً سابقاً لتعزيز الشمول التعليمي: ينبغي أن تتاح الفرص للناس بصرف النظر عن النوع الاجتماعي أو الإثنية أو القدرات أو الوضع الاجتماعي والاقتصادي أو محل الإقامة الثابت. وعلى الدول استخدام التصنيف المقترح لأسباب فقر البيانات لتحديد الفئات المستبعدة ومعالجة الثغرات المحددة. ثانياً، ينبغي أن يدعم تمويل مخصص أدوات للمتعلّمين مدى الحياة من أعمار وقدرات مختلفة، بمن فيهم ذوو احتياجات التعلّم الخاصة. ثالثاً، ينبغي أن يفحص التقييم التحيز في مصادر البيانات ومعالجتها الأولية وتصميم النماذج ومخرجاتها، بما فيه التحيز الجنساني والصور النمطية عن فئات معينة والتمييز ضد المهمشين وخطاب الكراهية.
رابعاً، ينبغي أن تدعم مؤشرات التنوّع اللغوي والثقافي لغات الأقليات والشعوب الأصلية عبر بيانات ما قبل التدريب والبُنى وطرائق التدريب، بما يمنع استبعادها أو إدخال تصفية ومعالجة لاحقة متحيزتين.
2. حماية الفاعلية البشرية
مع ازدياد قدرات الذكاء الاصطناعي التوليدي وأتمتته الجزئية للمعالجة الأساسية للمحتوى، قد يضعف الاستخدام التعليمي فاعلية الإنسان. فسهولة إنتاج المقالات والأعمال الفنية الأولية قد تشجع الاعتماد على محتوى مولّد من الخارج، وتقلل فرص إعمال العقل وتطوير المعارف والمهارات الأساسية. لذلك ينبغي أن تكون حماية الفاعلية وتعزيزها في صميم التصميم والتبنّي: يمكن للذكاء الاصطناعي تحدّي التفكير البشري وتوسيعه، لكن لا يجوز له أن يستولي عليه. ويقترح الدليل سبع ضمانات. أولاً، شرح بيانات الطلاب التي تُجمع، وكيفية استخدامها، وتأثيراتها الممكنة في الحياة التعليمية والاجتماعية. ثانياً، حماية الدافعية الذاتية والاستقلالية البشرية في القرارات والأفعال ضمن التدريس والتعلّم المدعومين بالذكاء الاصطناعي. ثالثاً، صون فرص تنمية الإدراك والمهارات الاجتماعية عبر ملاحظة الواقع والطرائق التجريبية كالتجارب والنقاش والاستدلال المنطقي.
رابعاً، ضمان التفاعل الاجتماعي والتعامل مع الأعمال البشرية، ومنع الإفراط في الاعتماد أو الإدمان. خامساً، استشارة الباحثين والمعلمين والطلاب قبل التبنّي واسع النطاق. سادساً، تشجيع التساؤل عن الطرائق التقنية والدقة والقيم المتضمنة والآثار التربوية. سابعاً، ينبغي أن يحتفظ المعلمون والطلاب بمسؤولية القرارات المتخذة بمساعدة الذكاء الاصطناعي.
3. مراجعة أدوات الذكاء الاصطناعي التعليمية ورصدها وتطوير نماذج تأسيسية ملائمة محلياً
ينبغي أن توجّه الأخلاق منذ التصميم ونهج دورة الحياة التطوير والنشر، لحماية المتعلّمين والمعلمين والعلاقات التعليمية من المخاطر التقنية أو الأخلاقية المتوقعة والأدوات غير الملائمة. وبالنسبة إلى الأنظمة القائمة، يوصي الدليل بالمراجعة والإجازة والرصد المستمر. وينبغي أن تفحص المراجعة الأخلاقية تقليل التحيز، وخصوصاً الجنساني، وتمثيل البيانات للغات والثقافات. وقبل الإجازة، يجب أن تتجنب الأنظمة الضرر المتوقع، وتثبت قيمة تعليمية، وتناسب أعمار المتعلّمين وقدراتهم، وتتوافق مع مبادئ المؤسسات المتعلقة بالمعارف والمهارات والنواتج المنشودة والقيم. ويتطلب استخدام البيانات والتفويض بالخدمات معلومات مفهومة عن المخاطر، وترتيبات وصاية مناسبة حيث تنطبق، وتواصلاً ملائماً للعمر، وإتاحة الوصول، وموافقة صحيحة.
ولا تحدد الإعاقة وحدها الأهلية القانونية؛ وتشرح الملاحظات التحريرية تصحيح التصنيف العام في الأصل استناداً إلى المادة 12 من اتفاقية حقوق الأشخاص ذوي الإعاقة. وينبغي أن تفحص المراجعات أيضاً التزييف العميق والأخبار الكاذبة وخطاب الكراهية والمخرجات الضارة أو غير المشروعة الأخرى، وأن تبحث التكاليف البيئية، بما فيها الكهرباء والمياه المستخدمتان في تدريب النماذج، في السياق المحلي.
ترى المقالة قصوراً في الملاءمة الثقافية واللغوية للنماذج التي كانت مهيمنة خارج الولايات المتحدة وأوروبا. ومع احترام المنافسة الدولية المشروعة، توصي بتطوير نشط لتحسين الملاءمة المحلية: دعم نماذج تأسيسية وطنية آمنة وقابلة للتحكّم، مع ترتيبات مناسبة للحقوق؛ وتطوير محوّلات توليدية تعليمية مدرّبة مسبقاً، أو نماذج EdGPT، واختبارها تكرارياً على أساس القيم المحلية والتنوّع اللغوي والثقافي ومعايير المناهج؛ ووضع حوافز لمنصات وإضافات تدعم الاستقصاء وتنوع خيارات التعلّم. والهدف منظومة تتطور فيها النماذج التأسيسية والتطبيقات التعليمية اللاحقة معاً حول اللغات والثقافات والمناهج المحلية.
4. تنمية كفاءات المعلمين والطلاب في الذكاء الاصطناعي
تُعد كفاءات الذكاء الاصطناعي، وخصوصاً لدى طلاب المدارس، أساسية للاستخدام الآمن والأخلاقي والهادف. وتفيد المقالة بأنه بحلول منتصف 2022 لم يكن لدى سوى نحو خمسة عشر بلداً مناهج مدرسية للذكاء الاصطناعي معتمدة وطنياً (UNESCO، 2022)، مما زاد إلحاح إتاحة محو الأمية الأساسية في الذكاء الاصطناعي للجميع. وكان إطار الطلاب قيد التطوير حينها ينظم الكفاءات بحسب الأبعاد والمستويات، ويجمع التعلّم الصفي واللامنهجي. وشملت أبعاده تصوراً للذكاء الاصطناعي محوره الإنسان، وأخلاقياته، وتقنياته وتطبيقاته الأساسية، وتصميم أنظمته. ووصفت مستويات الفهم والتطبيق والإبداع المعارف والمهارات والمواقف. ويحتفظ الجدول 2 بتلك المسودة التاريخية.
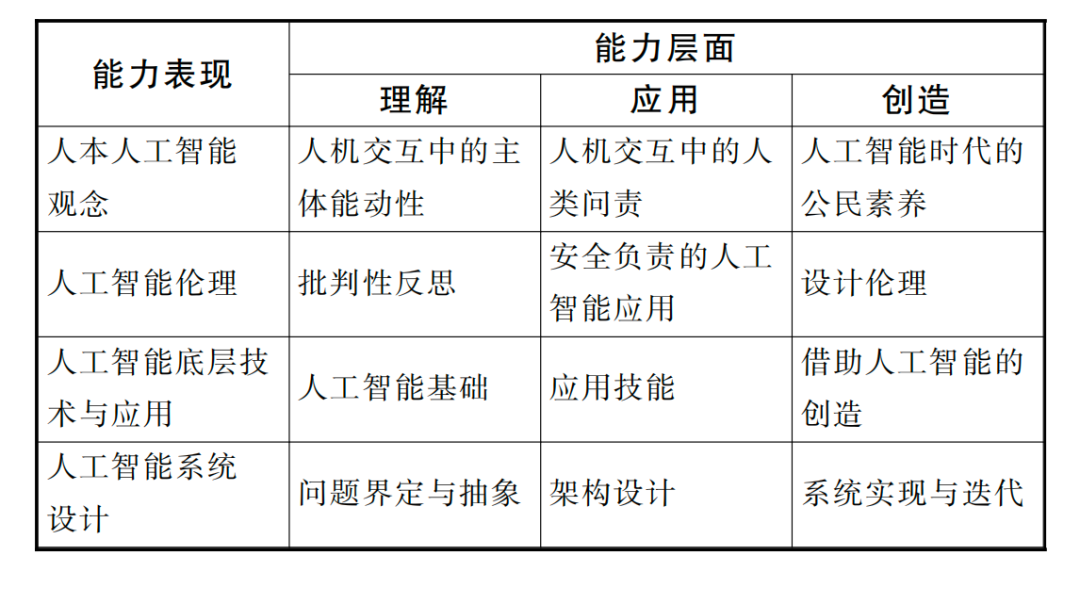
| بُعد الكفاءة | الفهم | التطبيق | الإبداع |
|---|---|---|---|
| تصور للذكاء الاصطناعي محوره الإنسان | الفاعلية في التفاعل بين الإنسان والذكاء الاصطناعي | المساءلة البشرية في التفاعل بين الإنسان والذكاء الاصطناعي | المواطنة في عصر الذكاء الاصطناعي |
| أخلاقيات الذكاء الاصطناعي | التأمل النقدي | استخدام الذكاء الاصطناعي بأمان ومسؤولية | الأخلاق منذ التصميم |
| أساسيات الذكاء الاصطناعي وتطبيقاته | أساسيات الذكاء الاصطناعي | مهارات التطبيق | الإبداع بمساعدة الذكاء الاصطناعي |
| تصميم أنظمة الذكاء الاصطناعي | تعريف المشكلة وتجريدها | تصميم البنية | التنفيذ والتكرار |
كانت اليونسكو تطوّر أيضاً إطاراً للمعلمين لتوجيه المعايير والتدريب الوطنيين نحو الاستخدام المناسب، ويعرضه الجدول 3 بوصفه المسودة التاريخية الأصلية. وشملت أبعاده الخمسة تصوراً للذكاء الاصطناعي محوره الإنسان، وأخلاقياته، وأساسياته وتطبيقاته، ودمج الذكاء الاصطناعي والتربية، والتنمية المهنية المدعومة بالذكاء الاصطناعي. ووصفت مستويات الاكتساب والتعمّق والإبداع النواتج للمعلمين ذوي نقاط الانطلاق المختلفة. واستهدف الاكتساب جميع المعلمين بعد التدريب، بمن فيهم من لم يسبق لهم الإعداد في الذكاء الاصطناعي ومن يعملون في بيئات شحيحة الموارد. واستهدف التعمّق المعلمين ذوي المعارف والخبرة المتوسطة. أما الإبداع فاستهدف أداء على مستوى الخبراء لدى من يمتلكون معارف واسعة وخبرة تطبيقية كبيرة في الذكاء الاصطناعي.
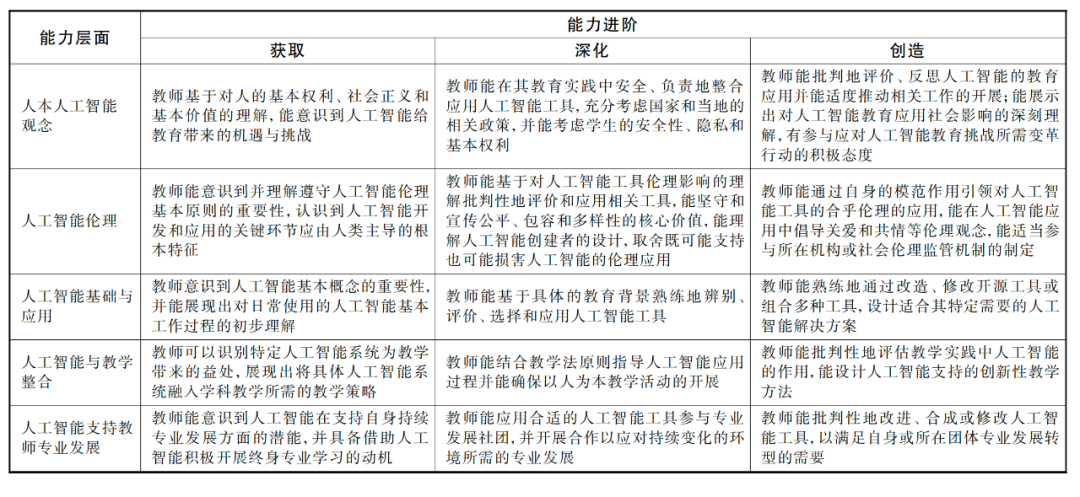
| بُعد الكفاءة | الاكتساب | التعمّق | الإبداع |
|---|---|---|---|
| تصور للذكاء الاصطناعي محوره الإنسان | إدراك الفرص والتحديات التعليمية للذكاء الاصطناعي انطلاقاً من فهم الحقوق الأساسية والعدالة الاجتماعية والقيم الجوهرية. | دمج أدوات الذكاء الاصطناعي بأمان ومسؤولية في الممارسة التعليمية، مع مراعاة السياسات الوطنية والمحلية وسلامة الطلاب وخصوصيتهم وحقوقهم الأساسية. | تقييم الذكاء الاصطناعي التعليمي والتأمل فيه نقدياً، ودفع العمل ذي الصلة على نحو مناسب، وفهم آثاره الاجتماعية والمشاركة الإيجابية في التغييرات اللازمة لمواجهة التحديات. |
| أخلاقيات الذكاء الاصطناعي | فهم أهمية المبادئ الأخلاقية وإدراك الاعتبارات المتمحورة حول الإنسان في جميع مراحل التطوير والاستخدام. | تقييم الأدوات وتكييفها نقدياً بحسب آثارها الأخلاقية؛ وصون الإنصاف والشمول والتنوّع، وفهم كيف يمكن لتصاميم المطوّرين ومفاضلاتهم أن تدعم التطبيق الأخلاقي أو تضر به. | تقديم نموذج للاستخدام الأخلاقي، والدعوة إلى الأفكار الأخلاقية ومشاركتها، والمشاركة في إنشاء رقابة مؤسسية أو مجتمعية على أخلاقيات الذكاء الاصطناعي. |
| أساسيات الذكاء الاصطناعي وتطبيقاته | إدراك المفاهيم الأساسية المهمة وإظهار فهم أولي لكيفية عمل أدوات الذكاء الاصطناعي اليومية. | تحديد الأدوات وتقييمها واختيارها وتطبيقها بكفاءة في سياقات تعليمية محددة. | اختيار أدوات مفتوحة المصدر أو تطويرها وتكييفها، أو الجمع بين أدوات، لتصميم حلول ذكاء اصطناعي لاحتياجات معينة. |
| دمج الذكاء الاصطناعي والتربية | تحديد الفوائد التدريسية للنظام وإظهار استراتيجيات دمجه في تعليم مادة دراسية. | توجيه تطبيقات الذكاء الاصطناعي بمبادئ تربوية وضمان أنشطة تعلّم محورها الإنسان. | تقييم دور الذكاء الاصطناعي في الممارسة التدريسية نقدياً وتصميم طرائق تربوية مبتكرة يدعمها الذكاء الاصطناعي. |
| التنمية المهنية المدعومة بالذكاء الاصطناعي | إدراك إمكانات الذكاء الاصطناعي للتنمية المهنية المستمرة والمحافظة على الدافعية للتعلّم المهني مدى الحياة بمساعدته. | استخدام أدوات مناسبة للمشاركة في مجتمعات مهنية والتعاون من أجل التطور في بيئات متغيرة. | تكييف الأدوات أو دمجها أو تعديلها نقدياً لتلبية احتياجات التنمية المهنية الشخصية أو المجتمعية. |
5. تشجيع التدريس الإبداعي والتعددية في بناء المعرفة وتنوّع التعبير
يصون التعليم الحضارة واستمرار تطورها من خلال التنوّع اللغوي والثقافي وبناء المعنى فردياً وأشكال التعبير المتنوعة. ويرى المؤلف أن إعادة إنتاج رؤى أصحاب بيانات التدريب للعالم قد تقمع وجهات نظر بديلة وتهدد هذه الرسالة. ولذلك ينبغي ألا يُعامل الذكاء الاصطناعي التوليدي مصدراً مرجعياً ذا سلطة للمعرفة في أي مادة. وعلى المعلمين والطلاب تقييم المخرجات نقدياً، مع إدراك فائدتها في الاسترجاع السريع للمعلومات والبحث في الأدبيات وتحويل الصيغ، وتوقع وجود محتوى غير موثوق. وينبغي أن يناسب التدريس المتعلّمين المعنيين، وأن يشجعهم على تقييم القيم المعروضة والافتراضات الثقافية، وعلى استخدام توليف الأدبيات ومعالجة البيانات للاستقصاء. ويحتاج الطلاب أيضاً إلى فرص كافية للتجربة والخطأ دون الذكاء الاصطناعي، والتجريب العملي، وملاحظة العالم الحقيقي.
6. بحث الآثار التعليمية الطويلة الأجل عبر التخصصات والقطاعات
رغم أن الدراسة تتتبّع العمليات والقيود المعروفة، فإن النماذج التأسيسية والتطبيقات اللاحقة سريعة التطور تتفاعل مع أوضاع تعليمية شديدة التنوّع وعدم اليقين. ولا ينبغي تقييم أهميتها التعليمية بصورة ضيقة انطلاقاً من العيوب الحالية أو من منظور تشككي محض. ويدعو الدليل إلى تعاون باحثي الذكاء الاصطناعي ومزوديه، ومنظّري التربية، وباحثي علم الأعصاب الإدراكي وغيرهم، والمعلمين والطلاب وأولياء الأمور. وينبغي أن يدرسوا معاً التأثيرات طويلة الأجل في إنتاج المعرفة وتعلّمها، وحقوق النشر والبحث، والمناهج والتقييم، والتعاون البشري والتنمية الاجتماعية، ثم يعيدوا النظر بعناية في أطر المناهج والأهداف التعليمية والامتحانات، ويُجروا تعديلات مناسبة على مستوى المنظومة.
لا ينبغي أن يبدأ تقييم الإمكانات التعليمية لتقدم تقني كبير في معالجة المحتوى وينتهي عند الادعاءات التجارية أو مكاسب إنتاجية إنشاء المحتوى. بل تظل نقطة الانطلاق المبادئ المتمحورة حول الإنسان. وعلى التربويين فحص الخلافات عبر دورة حياة الذكاء الاصطناعي كلها ومعالجة آثارها في الإنصاف والشمول والقيم والتنوّع اللغوي والثقافي. ويرى المؤلف في خاتمته أن ذلك ضروري لمنع تحول الأفراد والمجتمعات، بوصفهم مشاركين في التعليم ومستفيدين منه، إلى موضوعات تجريب أو خدم لذكاء اصطناعي تحركه المصالح التجارية.
المراجع
- Bishop, J. M.(2021). Artificial Intelligence is stupid and causal reasoning won't fix it[J]. Frontier in Psychology, 2021(11):1-18.
- Bommasani, R., Hudson, D. A., Adeli, E., et al (2021). On the opportunities and risks of foundation models[DB/OL]. [2023-10-16]. https://crfm.stanford.edu/report.html.
- Bommasani, R., Klyman, K., Longpre, S. et al.(2023). The foundation model transparency index.[DB/OL]. [2023-10-10]. https://arxiv.org/abs/2310.12941.
- Candelon, F., Krayer, L., Rajendran,S. et al.(2023). How people can create and destroy value with generative AI[DB/OL]. [2023.10-12]. https://www.bcg.com/publications/2023/how-people-create-and-destroy-value-with-gen-ai.
- European Parliament(2023). MEPs ready to negotiate first-ever rules for safe and transparent Al. [DB/OL. [2023-10-18]. https://digital-strategy.ec.europa.eu/en/policies/european-approach-artificial-intelligence.
- European Union(2016). General Data Protection Regulation[DB/OL].[2023-08-09]. http://data.europa.eu/eli/reg/2016/679/oj.
- GitHub(2023). Hallucination Leaderboard. [DB/OL]. [2023-11-08]. https://github.com/vectara/hallucination-leaderboard.
- Home Security Hero(2023). State of deepfakes: Realities,threats, and impact [DB/OL].[2023-11-11]. https://www.homesecurity-heroes.com/state-of-deepfakes/#key-findings.
- Lin, B.(2023). Al is generating security risks faster than companies can keep pp.[DB/OL].[2023-08-25]. https://www.wsj.com/articles/ai-is-generating-security-risks-faster-thancompanies-can-keep-up-a2bdedd4.
- Lutkevich, B.(2023). Model collapse explained: How synthetic training data breaks AI [DB/OL].[2023-10-28]. https://www.techtarget.com/whatis/feature/Model-collapse-explained-How-synthetic-training-data-breaks-AI.
- Marwala, T(2023). Algorithm Bias: Synthetic Data Should Be Option of Last Resort When Training Al Systems.[DB/OL]. [2023-07-31].https://unu.edu/article/algorithm-bias-synthetic-data-should-be-option-last-resort-when-training-ai-systems.
- Miao, F.(2022). Al and education: Guidance for policymakers|M]. Paris, UNESCO.
- Miao, F.et al(2023). Guidance on generative Al in education and research [M]. Paris: UNESCO 2023.
- 苗逢春(2022). 教育人工智能伦理的解析与治理: 人工智能伦理问题建议书的教育解读[J].中国电化教育,2022(6):22-36.
- 苗逢春(2023). 数字文明变局中的教育数字化转型[J].电化教育研究,(2):47-63,91.
- Omiye, J. A., Lester, J.C., Spichak, S. et al.(2023). Large language models propagate race-based medicine[J]. Digital Medicine, 2023(6):195:1-4.
- Pearl, J.,& Mackenzie, D.(2018). The book of why: The new science of cause and effect [M]. NY: Basic Books.
- Robertson, K.(2023). News group says A. I. Chatbots heavily rely on news content [EB/OL]. The New York Times. https://www.nytimes.com/2023/10/31/business/media/news-artificial-intelligence-chatbots.html.
- Stanford University(2019). The 2019 Al Index Report[DB/OL].[2023-1018]. https://hai.stanford.edu/ai-index-2019.
- The White House(2023). Executive order on the safe, secure, and trustworthy development and use of artificial intelligence [OL] The White House. https://www.whitehouse.gov/briefing-room/presidential-actions/2023/10/30/executive-order-on-the-safe-secure-and-trustworthy-development-and-use-of-artificial-intelligence/.
- Thompson, A. D.(2023). Contents of GPT-3 & the pile v1[EB/OL].[2023-1018]. https://lifearchitect.ai/models/#gpt-3-top-10.
- Touvron H, Martin, L, Stone, K et al.(2023) Llama 2: Open foundation and fine-tuned chat models[DB/OL][2023-10-16]. https://ai.meta.com/research/publications/llama-2-open-foundation-and-fine-tuned-chat-models.
- UNCTAD(2023). Data protection and privacy legislation worldwide [DB/OL].[2023-07-18]. https://unctad.org/page/data-protection-and-privacy-legislation-worldwide.
- UNESCO(2019). Beijing consensus on artificial intelligence and education[S].Paris, UNESCO.
- UNESCO(2022). Recommendation on the Ethics of Artificial Intelligence[S]. Paris, UNESCO.
- Zhang, D., Finckenberg-Broman, P., Hoang, T., et al(2023). Right to be forgotten in the era of large language models: Implications, challenges, and solutions [DB/OL]. arXiv: 2307.03941v3 [cs.CY]22 Sep 2023.
- 中共中央、国务院(2022). 关于构建数据基础制度更好发挥数据要素作用的意见 [EB/OL].[2023-10-23]. https://www.gov.cn/zhengce/2022-12/19/content_5732695.htm.
البيانات الأصلية للمجلة باللغة الإنجليزية — أرشيف
Generative AI and its Uses in Education: Foundational Controversies and Responding Strategies
MIAO Fengchun 1,2
1. National Engineering Laboratory for Cyberlearning and Intelligent Technology, Faculty of Education, Beijing Normal University,
2. Headquarters of UNESCO
Abstract: The paper is the second edition of a serials of interpretative articles on the Guidance on generative AI in education and research released by UNESCO, and the main aim of this edition is to examine the controversies around generative AI and its use in education. Based on an analysis of how it works, the development and deployment of generative AI have triggered the following controversies: worsening digital poverties, outpacing domestic governance, the collection of pre-training data without consent, the unexplainability of the architecture, the foundational models can't under the real world, the outputs of generative AI is polluting the internet, the outputs are projecting dominant values, amplifying the creation and dissemination of illegal deepfakes. Generative AI poses direct and most profound threats on the core values of education including inclusion, equity, cultural and linguistic diversities, pluralism in knowledge construction and expression, and therefore, those core values should be upheld as the logic base when examining the proportionality of generative AI to service purposes of education. Policy-makers and practitioners should follow the logic roadmap of "prioritizing regulation, ensuring inclusion, and guiding applications" to enhance the system-wide governance regulations in order to ensure trustable, self-automatic, and locally relevant eco-systems of generative AI for education, followed by developing capacities and guidance to steer proper uses of generative AI in education.
Keywords: generative AI;content processing across symbolic representations of human thinking;sources of pre-training datasets;equity, inclusion, cultural and linguistic diversities
ملاحظات تحريرية ومصادر التحقق
- تواريخ النشر: تشير المجلة إلى فبراير 2024، المجلد 30، العدد 1، الصفحات 4–15، والمعرّف DOI 10.13966/j.cnki.kfjyyj.2024.01.001. ويُحتفظ بصورة منفصلة بتاريخ الأرشفة الأصلي للموقع، 27 يناير 2024. المقالة الأصلية; DOI; عدد المجلة
- الأسماء التقنية: استند ChatGPT الذي أُطلق في 30 نوفمبر 2022 في البداية إلى سلسلة GPT-3.5. ولا تعادل وحدة الترميز بالضرورة بايتاً. وطوّرت ستانفورد Alpaca بالضبط الدقيق لنموذج LLaMA 7B من Meta؛ وقد نسب الأصل Alpaca إلى Meta خطأً. وصُححت هذه التسميات. إطلاق ChatGPT; Alpaca من ستانفورد
- حجم النماذج وبيانات التدريب: لم يؤكد التقرير التقني الرسمي ادعاء الأصل أن GPT-4 يضم «1.8 تريليون» معلمة، إذ لم يفصح عن حجم النموذج. وتبقى تقديرات مدوّنة GPT-3 ونسب مصادرها ولغاتها وأرقام القدرة الحاسوبية للفترة 2012–2019 مواد تاريخية منسوبة إلى مصادرها، لا أوصافاً لـChatGPT الأول أو النماذج اللاحقة. التقرير التقني لـGPT-4
- التنظيم التاريخي: شهد 9 ديسمبر 2023 اتفاقاً سياسياً مؤقتاً في الاتحاد الأوروبي؛ أما قانون الذكاء الاصطناعي الرسمي فهو تشريع عام 2024. والاسم الكامل للنص الصيني هو التدابير المؤقتة لإدارة خدمات الذكاء الاصطناعي التوليدي، التي أُعلنت في 13 يوليو 2023 وبدأ نفاذها في 15 أغسطس. وتظل مقترحات التعديل والمقارنات بالأمر الأمريكي تحليلاً تاريخياً. اتفاق الاتحاد الأوروبي 2023; قانون الاتحاد الأوروبي للذكاء الاصطناعي 2024; النص الأصلي لهيئة الفضاء السيبراني الصينية
- العمر والوسم: الثالثة عشرة والسادسة عشرة توصيتان يناقشهما النص وليستا سنين قانونيتين عالميتين للمحادثة. وتتعلق المادة 8 من GDPR بموافقة الأطفال على معالجة البيانات ضمن شروط محددة. وصُححت الإشارة الأخيرة إلى «البالغين» في الفقرة الأصلية إلى «القاصرين». وينبغي التمييز بين متطلبات الوسم أو الشفافية في المادة 12 من التدابير الصينية والمادة 50 من قانون الاتحاد الأوروبي للذكاء الاصطناعي لعام 2024، وبين قواعد حماية البيانات في GDPR. GDPR; النص الأصلي لهيئة الفضاء السيبراني الصينية; قانون الاتحاد الأوروبي للذكاء الاصطناعي 2024
- محو التعلّم: ادعاء الاستحالة في الأصل مطلق أكثر مما ينبغي. فنسخة Zhang وزملائه المشار إليها، المؤرخة 22 سبتمبر 2023، تناقش الخصوصية التفاضلية ومحو التعلّم الآلي وتحرير النماذج وهندسة التعليمات. ويُحتفظ بمشكلة إزالة تأثير البيانات، مع هذه المسارات التقنية وصعوبات تنفيذها. الدراسة المذكورة لعام 2023
- معدلات الهلوسة: تخص النسب المذكورة مهمة Vectara التاريخية لقياس أمانة التلخيص. واستخدمت نسخة 1 نوفمبر 2023 عدد 831 مستنداً لخّصتها جميع النماذج المقارنة. وليست هذه معدلات خطأ عامة للإجابة عن الأسئلة، ولا تثبت معدلات أخطاء اللغة الصينية. ويربط النص بإيداع تاريخي ثابت بدلاً من القائمة الحالية المتغيرة. قائمة Vectara التاريخية
- إحصاءات التزييف العميق: حلّل التقرير القطاعي المذكور 95,820 مقطعاً ووصف نمواً قدره 550% منذ 2019. وتتعارض عبارة الأصل «نحو مليون مقطع جديد» مع المصدر؛ ولا ينبغي مساواة «5.5 أضعاف» بنسبة النمو. وتحتفظ نتيجتا 98% و99% بنسبتهما إلى مسح التقرير، ولا تُعرضان كتعداد عالمي أو كأرقام حالية. تقرير التزييف العميق 2023
- الإعاقة والتفويض: جمع الأصل القاصرين والأشخاص ذوي الإعاقة عموماً بوصفهم مفتقرين إلى كامل «الأهلية الجنائية»، وهو ليس قاعدة عامة صحيحة للتفويض. وتميّز هذه الطبعة بين الوصاية المطبقة قانوناً والمعلومات الملائمة للعمر وإتاحة الوصول ودعم اتخاذ القرار والموافقة الصحيحة. وتقر المادة 12 من اتفاقية حقوق الأشخاص ذوي الإعاقة بالمساواة في الأهلية القانونية وبالدعم والضمانات اللازمين لممارستها. اتفاقية حقوق الأشخاص ذوي الإعاقة
- الأطر والأحكام البحثية: يحتفظ الجدولان 2 و3 بالمسودات التي كانت قيد التطوير عند كتابة المقالة؛ وتُعرض أطر 2024 اللاحقة في مادة مستقلة. والأحكام المتعلقة بالفهم والمعرفة وحقوق النشر والإبداع هي حجج المؤلف في ذلك الوقت. وتنتمي الإحصاءات ونتائج المقارنات إلى نطاق الدراسات الأصلية. المقالة الأصلية
المصدر: Miao, Fengchun (2024)، Generative AI and its Uses in Education: Foundational Controversies and Responding Strategies، Open Education Research، 30(1)، 4–15. حُفظ الانتساب المؤسسي والبيانات الأصلية باللغة الإنجليزية من الأرشيف. وتبقى الحقوق ذات الصلة للمجلة والمؤلفين.
بحوث وموارد ذات صلة
للمزيد: دليل اليونسكو بشأن الذكاء الاصطناعي التوليدي؛ المقالة الأولى عن الملاءمة التعليمية؛ تغطية أطر كفاءات الذكاء الاصطناعي للمعلمين والطلاب لعام 2024؛ موارد التربية الخاصة والتعليم الدامج.
الرابط الأصلي: https://aiedchair.bnu.edu.cn/news-6398-ar/