Este artículo de Fengchun Miao se publicó en Open Education Research, volumen 30, número 1 de 2024, como segunda interpretación de la Guía para el uso de IA generativa en educación e investigación de la UNESCO. Esta edición respeta el alcance íntegro del texto original, incluidas tres figuras, veintisiete referencias y los metadatos originales en inglés, y ofrece secciones estructuradas y tablas de texto accesibles. Los juicios técnicos, las estadísticas y el análisis de políticas deben leerse en el contexto de su redacción en 2023; las correcciones de nombres, cifras y descripciones jurídicas se documentan en las notas editoriales.
Fengchun Miao — afiliaciones 1 y 2
1. Centro Nacional de Investigación en Ingeniería del Ciberaprendizaje y la Tecnología Inteligente, Universidad Normal de Beijing.
2. Sede de la UNESCO.
Resumen: Este es el segundo artículo de una serie que interpreta la Guía para el uso de IA generativa en educación e investigación de la UNESCO. Examina las controversias fundamentales de la IA generativa y sus aplicaciones educativas. El análisis de las limitaciones técnicas a lo largo de su funcionamiento identifica problemas relacionados con el agravamiento de la pobreza de datos, la opacidad tecnológica y las carencias de la gobernanza nacional, la recopilación no autorizada de datos de entrenamiento, la dificultad de explicar las arquitecturas de los modelos, la comprensión del mundo real por los modelos fundacionales, la contaminación de internet con contenido generado, la proyección de valores dominantes y la propagación de falsificaciones sintéticas ilícitas.
El artículo sostiene que la IA generativa puede afectar profundamente valores educativos como la igualdad, la inclusión, la capacidad de acción del alumnado, la diversidad de valores, lenguas y culturas, y el pluralismo en la construcción del conocimiento. Estos valores deben ser el punto de partida para evaluar su idoneidad educativa. Los responsables de políticas y los profesionales deberían seguir una vía de «priorizar la regulación, garantizar la inclusión y orientar las aplicaciones», reforzando la regulación y su cumplimiento en todo el sistema para establecer ecosistemas educativos de IA generativa seguros, fiables, controlables de manera autónoma y adecuados al contexto local. El desarrollo de capacidades y la orientación práctica deberían apoyar después un uso educativo apropiado.
Palabras clave: inteligencia artificial generativa; procesamiento de contenidos; procedencia de los conjuntos de datos de entrenamiento; equidad, inclusión y diversidad lingüística y cultural.
Introducción
En noviembre de 2022, OpenAI lanzó ChatGPT, inaugurando una nueva etapa en el paso de la IA generativa de la investigación al uso comercial y público. La versión inicial de ChatGPT se basaba en la serie GPT-3.5; aquí se corrige la denominación «ChatGPT-3» del original a partir de la información de lanzamiento del desarrollador, como explican las notas editoriales. El artículo agrupa los efectos y las respuestas regulatorias durante aproximadamente el primer año posterior al lanzamiento en cuatro ámbitos.
1. Monopolio y diversidad. El artículo describe a OpenAI, Google y Meta como actores que establecieron posiciones de dominio vertical que abarcaban los modelos fundacionales, la infraestructura de red y el procesamiento de texto, imágenes, audio y vídeo. Otras grandes empresas y las comunidades de modelos abiertos buscaban modelos fundacionales abiertos, una oferta más amplia de plataformas y mayor diversidad lingüística y cultural mediante la competencia en investigación y desarrollo de ecosistemas.
2. Aplicación y sustitución. La IA generativa se extendía rápidamente por las actividades comerciales y aceleraba la automatización de puestos de trabajo en los sectores afectados.
3. Controversia y gobernanza. Las preocupaciones por la seguridad y la ética pasaban de inquietudes teóricas a casos judiciales concretos. La confianza en el potencial transformador coexistía con la preocupación por las consecuencias humanas, lo que aceleró actuaciones legislativas específicas en países y jurisdicciones como China, Estados Unidos y la Unión Europea.
4. Visión y realidad. La rápida aparición de la IA generativa alteraba y transformaba la educación y otros servicios sociales, mientras persistía una distancia considerable entre esos avances y las evaluaciones razonadas de su idoneidad educativa y utilidad práctica para el alumnado local, especialmente para los menores. Las opiniones públicas seguían divididas sobre sus posibles consecuencias para la seguridad y la ética.
La Guía para el uso de IA generativa en educación e investigación de la UNESCO, publicada en septiembre de 2023 y denominada en adelante la Guía (Miao, 2023), reconstruyó los principios de funcionamiento de la tecnología e identificó sistemáticamente ocho controversias fundamentales. Examinó sus implicaciones educativas y propuso respuestas de gobernanza pública, políticas educativas y un marco práctico de interacción entre personas y máquinas adecuado a sus participantes.
Como segunda interpretación de la Guía, este estudio examina sistemáticamente las controversias sobre la IA generativa y la educación, e identifica respuestas de gobernanza y recomendaciones prácticas según sus causas y los actores responsables. Su interpretación se apoya en tres supuestos relacionados entre sí:
Primero, la innovación en IA, la seguridad y la fiabilidad, y la aplicación social inclusiva e igualitaria no deberían constituir un trilema. Los tres objetivos deberían avanzar conjuntamente y reforzarse entre sí.
Segundo, el estudio considera que las amenazas más directas y profundas afectan a la igualdad y la inclusión educativas, la capacidad de acción del alumnado, la diversidad de valores, lenguas y culturas, y el pluralismo en la construcción del conocimiento. Por ello, estos valores esenciales deberían ser el punto de partida para examinar la idoneidad educativa de la IA generativa.
Tercero, las aplicaciones educativas deberían seguir la lógica de «priorizar la regulación, garantizar la inclusión y orientar las aplicaciones».
I. Los orígenes técnicos de las controversias
El debate sobre las controversias de la IA generativa en educación debe basarse en cómo funciona la tecnología, sus limitaciones y sus efectos sociales observables y potenciales.
1. Principios de funcionamiento, procedencia de los datos de entrenamiento y distribución lingüística
La Guía define la IA generativa a partir de la simulación, por la IA, de los sistemas simbólicos mediante los que se representa el pensamiento humano: produce automáticamente contenido en respuesta a instrucciones expresadas mediante esos sistemas. Sus capacidades de reconocimiento de patrones y producción de contenido aumentaban en ámbitos como el texto, el habla, el sonido, las imágenes, el vídeo y el código informático. Según el artículo, la generación de texto utiliza redes neuronales artificiales y modelos basados en la arquitectura Transformer, habitualmente denominados grandes modelos de lenguaje: sistemas de aprendizaje profundo entrenados con información recopilada de páginas web, conversaciones en redes sociales y otros medios en línea.
Los modelos generativos preentrenados para texto o habla aprenden patrones sintácticos en los conjuntos de entrenamiento y adquieren la capacidad de responder a instrucciones aplicando repetidamente esos patrones mediante ciclos de entrenamiento, prueba y optimización. Las principales etapas son las siguientes:
1. Dividir la instrucción en tókenes que la IA pueda procesar y transmitirlos a un transformador generativo preentrenado. Se emplea «token» en lugar del término inexacto «byte» del texto chino original.
2. A partir de los patrones lingüísticos identificados en los datos de entrenamiento, predecir la probabilidad de determinadas palabras o expresiones en su contexto. Las predicciones estadísticas combinan palabras y relaciones sintácticas para formar respuestas coherentes y predicen las palabras o expresiones que tienen más probabilidades de aparecer a continuación.
3. Convertir las palabras o expresiones predichas en texto legible o habla inteligible. Los mecanismos de protección filtran resultados claramente ilícitos o inadecuados, y un procesamiento adicional mejora la sintaxis y la comprensibilidad para que se asemejen a las humanas. El proceso se repite hasta producir una respuesta completa.
El artículo explica la generación de imágenes y música principalmente mediante redes generativas adversarias (GAN), que pueden combinarse con autocodificadores variacionales. También menciona los modelos de difusión como otra vía de generación de imágenes. Una GAN tiene dos componentes que compiten: un generador y un discriminador. En respuesta a una instrucción, el generador identifica combinaciones de elementos visuales o musicales y produce una imagen o un segmento musical inicial. El discriminador los compara con ejemplos reales. El generador ajusta entonces sus parámetros en función de la comparación. Tras numerosas iteraciones de entrenamiento, las imágenes o la música generadas resultan cada vez más realistas.
Las capacidades de un transformador generativo preentrenado dependen de su arquitectura, sus métodos de entrenamiento, la calidad y cantidad de los datos de preentrenamiento y los parámetros del modelo. Los parámetros son valores numéricos que determinan cómo las redes neuronales procesan las entradas y producen salidas, codificando características aprendidas durante el entrenamiento. Su definición y escala afectan al rendimiento. GPT-3 utilizaba aproximadamente 175.000 millones de parámetros. El artículo original reproduce una afirmación no confirmada según la cual GPT-4 tenía «1,8 billones»; el informe técnico oficial de GPT-4 no reveló el tamaño del modelo, como explican las notas editoriales.
El panorama de modelos de aquel momento incluía los productos ChatGPT de OpenAI; Alpaca, desarrollado por Stanford mediante el ajuste fino de LLaMA de Meta; los modelos Llama de Meta; Bard de Google, entonces basado en PaLM 2; y el modelo multimodal Gemini. Las fuentes de entrenamiento incluían páginas web rastreadas, conversaciones de redes sociales, libros de bibliotecas en línea y enciclopedias. Para GPT-3, el artículo cita un corpus estimado de aproximadamente 1 TB (Thompson, 2023), compuesto en torno a un 61,75 % por materiales de Common Crawl recopilados de internet desde 2012; un 18,86 % por publicaciones y debates de Reddit con más de tres votos positivos; un 15,9 % por libros de Library Genesis y Smashwords; y un 3,49 % por Wikipedia. Son estimaciones históricas de las fuentes del artículo, no una descripción del ChatGPT actual.
El texto subraya el predominio de las lenguas de Estados Unidos y Europa en los modelos entonces dominantes: en el corpus de GPT-3 citado, el inglés representaba aproximadamente el 92,65 %, las demás lenguas europeas más del 5 % y el chino menos del 0,1 %. En Llama 2 de Meta, el inglés suponía el 89,7 %, el chino el 0,13 % y las otras quince lenguas principales apenas habían cambiado (Touvron et al., 2023). El rápido crecimiento de los datos y los parámetros también exigía más computación de alto rendimiento. Para 2012–2019, el artículo cita un periodo de duplicación de entre tres y cuatro meses en la computación empleada para entrenar los principales modelos de IA (Universidad de Stanford, 2019).
2. Avances integrados en el procesamiento de contenidos y posibles límites de esta categoría tecnológica
El estudio describe avances integrados en tecnologías centrales y auxiliares: métodos de aprendizaje profundo combinados, arquitecturas optimizadas, perfeccionamiento de conjuntos de parámetros de cientos de miles de millones, acumulación dinámica de datos de entrenamiento entre plataformas y mayor capacidad de cálculo para enormes conjuntos de datos. Juntos podrían producir un «efecto de aceleración descontrolada». Primero, el progreso en el procesamiento y la presentación de información mediante distintos sistemas simbólicos amplía las capacidades tecnológicas y acelera la investigación en chips de IA, supercomputación y modelos de procesamiento de datos. El carácter fundamental de estos avances explica la amplia adopción de la expresión «modelos fundacionales», propuesta por investigadores de Stanford en 2021 (Bommasani, 2021).
Segundo, la IA generativa impulsaba cambios en navegadores, buscadores e infraestructura digital, se convertía en un punto importante de control de la seguridad nacional de los datos y de la privacidad personal, y presionaba para actualizar las normas y los sistemas de seguridad. Tercero, ofrece herramientas de productividad para actividades económicas y sociales que tienen como fines directos o indirectos producir o sintetizar contenido, con posibles grandes cambios en la producción. Sin embargo, el autor sostiene que su capacidad para aumentar la eficiencia y transformar sectores como la educación, cuyos fines van más allá de producir contenido, podría estar considerablemente limitada.
Al examinar las vías técnicas conocidas en aquel momento, el autor caracteriza los logros de las redes neuronales como ajustes estadísticos de curvas, distintos del razonamiento humano que combina relaciones temporales, espaciales y causales (Pearl y Mackenzie, 2018). Si el aprendizaje profundo fuera la vía computacional adecuada para resolver problemas de manera humana, la continuidad de los avances podría acabar produciendo una aceleración descontrolada más allá del procesamiento de contenidos: una hipotética singularidad en la que la IA superase la inteligencia humana y siguiese una trayectoria relativamente independiente del control humano.
No obstante, el autor sostiene que los principios entonces conocidos de los modelos fundacionales parecían permanecer dentro de la síntesis de contenidos, el procesamiento mediante representaciones simbólicas y la conversión de formatos, sin constituir una vía técnica hacia la comprensión humana. En esta interpretación, se arriesgan a cometer un «error de categoría» (Bishop, 2021). Seguía abierta la cuestión de si los avances observados representaban un salto de rendimiento anterior a ese límite de categoría.
II. Controversias fundamentales sobre la IA generativa
El artículo entiende estas controversias como preocupaciones humanas surgidas de la interacción entre personas y máquinas, y las examina desde dimensiones técnicas y humanísticas. La dimensión técnica sigue el ciclo de vida de los sistemas de IA: producción y almacenamiento de datos; acceso y control de los datos y de los equipos que los procesan; efectos observables de las predicciones y decisiones basadas en datos y algoritmos; e IA encarnada, incluidas las interfaces y los dispositivos inteligentes. La dimensión humanística abarca la existencia individual, la interacción social, la gobernanza nacional y las relaciones con los entornos y los ecosistemas.
Sus niveles interconectados incluyen a las personas, los grupos que interactúan entre sí, las relaciones organizadas como Estados soberanos y las interacciones de las personas con su entorno (Miao, 2022). Antes de una adopción a gran escala, los usuarios deberían examinar la recopilación y el uso de datos de entrenamiento, las arquitecturas básicas y los resultados basados en patrones, evaluando amenazas inmediatas y efectos potenciales para las personas, las sociedades y los países.
1. Extracción de la productividad de los datos: agravamiento de la pobreza de datos y digital
El autor considera que las Opiniones sobre la construcción de sistemas básicos de datos para aprovechar mejor los datos como factor de producción, publicadas en China en 2022 por el Comité Central del PCCh y el Consejo de Estado, marcan jurídicamente una era de protección de la propiedad y los derechos sobre los datos. Desde esta perspectiva, recopilar gratuitamente datos de personas y empresas y obtener beneficios de modelos entrenados con ellos sitúa en primer plano controversias antes menos visibles sobre la extracción del valor de los datos entre fronteras y sectores.
Acceder a datos de calidad, utilizarlos y producir continuamente datos de calidad en línea y mediante transformación se han convertido en condiciones importantes para el desarrollo económico nacional y las oportunidades digitales individuales. Los países sin acceso a datos, capacidades para extraerlos o supercomputación, y las personas que no pueden pagar por aplicaciones basadas en datos, sufren «pobreza de datos» (Marwala, 2023). El autor sostiene que entrenar modelos fundacionales con datos recopilados gratuitamente y cobrar después por sus servicios puede intensificarla. Esta producción requiere tres condiciones: innovación en arquitecturas y métodos de entrenamiento de IA, conjuntos de datos muy grandes y capacidad de supercomputación.
En el periodo analizado, el autor consideraba que solo Estados Unidos, China, la UE y unas pocas empresas tecnológicas de gran tamaño reunían simultáneamente estas condiciones. Los países pobres en datos se rezagaban aún más y quedaban excluidos de la investigación central sobre modelos fundacionales. Una adopción más amplia acelera la generación de datos y la iteración técnica entre los líderes y refuerza el ciclo de la brecha digital.
Para revertir este ciclo, los países deberían identificar y abordar los puntos débiles a lo largo de la producción de datos. La propuesta de «clasificación de las causas de la pobreza de datos» incluye la cobertura de internet, la alfabetización digital de toda la población, el tráfico de datos asequible, el talento en IA y los incentivos a la innovación, el acceso a chips de IA y supercomputación de capacidad suficiente, y la posibilidad de entrenar modelos locales con datos nacionales o internacionales fiables. Otra cuestión es si medidas internacionales, como un impuesto sobre el uso de datos, deberían redistribuir el valor excedente cuando los proveedores transnacionales recopilan grandes cantidades de datos de países de renta baja.
Definir y rastrear el volumen utilizado, calcular el valor excedente y los criterios tributarios, y equilibrar la innovación con los intereses básicos de las poblaciones pobres en datos seguirían siendo problemas de frontera de difícil solución en la gobernanza internacional de los datos.
2. Gobernanza en las jurisdicciones donde se prestan servicios: pérdida del control nacional
Los servicios transfronterizos de IA generativa deberían someterse a la gobernanza de las jurisdicciones a las que sirven, pero la opacidad tecnológica dificulta esa tarea. Primero, los proveedores dominantes pueden negar información básica de transparencia a organismos académicos independientes o resistirse a sus evaluaciones (Bommasani, 2023). Segundo, las protecciones de propiedad intelectual en los países de origen de los proveedores, principalmente Estados Unidos en esta exposición, pueden restringir el acceso de los países usuarios a las tecnologías fundamentales y dificultar el examen de los sistemas y las aplicaciones (Lin, 2023).
Tercero, pese a los llamamientos a pausar el desarrollo y alinearlo con la gobernanza pública, la iteración impulsada por el capital avanza mucho más deprisa que la elaboración de normas, situando a las autoridades en clara desventaja técnica al abordar cuestiones jurídicas y éticas.
El artículo describe varios niveles de ausencia o retraso institucional. Primero, informa de que en julio de 2023 había 137 países con marcos de protección de datos personales, por lo que casi un tercio carecía de leyes básicas de privacidad (UNCTAD, 2023). Segundo, unos 67 países tenían estrategias nacionales de IA antes de la Guía; Ruanda y la República Dominicana anunciaron las suyas después. Tercero, señala que solo unos 40 países contaban con políticas de ética de la IA en julio de 2023. Cuarto, el autor identifica a China, Estados Unidos y la UE como las jurisdicciones que entonces habían examinado la protección de la propiedad intelectual de las obras sintéticas y emitido posiciones claras sobre su gestión.
China había publicado las Medidas provisionales para la gestión de los servicios de inteligencia artificial generativa antes de la Guía. Estados Unidos emitió su orden ejecutiva sobre una IA segura y fiable a finales de octubre de 2023 (The White House, 2023). El 9 de diciembre de 2023, los negociadores del Parlamento Europeo y del Consejo alcanzaron un acuerdo político provisional sobre el Reglamento de IA. La norma formal corresponde a 2024; la referencia original a su «aprobación» en diciembre de 2023 no debe interpretarse como aprobación formal y entrada en vigor en ese momento, como explican las notas editoriales.
3. Derechos de autor sobre los datos de preentrenamiento: uso de contenidos sin autorización
La recopilación y el uso de conjuntos de datos de entrenamiento suscitan importantes controversias sobre la autorización para utilizar datos de personas y organizaciones y contenidos protegidos por derechos de autor.
Los modelos se entrenan con texto, sonido, código, imágenes y otros materiales rastreados en internet. El artículo sostiene que los principales modelos recopilaron a menudo esos materiales sin autorización previa, lo que provocó disputas y litigios de propiedad intelectual, incluidas alegaciones al amparo de legislación de protección de datos como el RGPD (Unión Europea, 2016). Destaca el sector de la prensa: a finales de octubre de 2023, la News/Media Alliance estadounidense, que representaba a más de 2.200 editores de noticias, denunció que ChatGPT había utilizado millones de noticias y reportajes de pago como material de entrenamiento sin permiso de los titulares y trató de obtener por vías jurídicas la retirada de Common Crawl de contenidos supuestamente recopilados de forma ilícita (Robertson, 2023).
Estas prácticas también plantean el derecho de supresión, por el que los titulares pueden solicitar la eliminación de datos recopilados sin autorización. Una vez que los datos personales han influido en un modelo entrenado, el autor considera que eliminar esa influencia resulta muy difícil. El original emplea expresiones absolutas como «no existe posibilidad de desaprendizaje» e «imposible»; aquí se matizan como parte de su argumentación de entonces. La investigación citada aborda el desaprendizaje automático, la edición de modelos y otras vías, como explican las notas editoriales. El problema incluye eliminar respuestas aprendidas que reflejen opiniones y características lingüísticas o culturales del titular de los datos (Zhang, 2023).
4. Explicabilidad de la arquitectura: resultados de modelos opacos
El artículo describe las arquitecturas de las redes neuronales como cajas negras, con dificultades para explicar las configuraciones de nodos y capas, las definiciones de los parámetros y los cálculos. Los avances recientes amplifican estas preocupaciones. Aunque el enfoque general, incluidos los algoritmos, sea parcialmente explicable, resulta difícil dar cuenta de parámetros concretos y de sus contribuciones relativas a un resultado. Los grandes modelos fundacionales utilizan extensos conjuntos de parámetros y pesos para reconocer patrones y producir respuestas, por lo que es difícil explicar por qué un modelo particular genera una respuesta determinada. El autor prevé que el crecimiento de la escala y de la complejidad de la arquitectura agravará el problema.
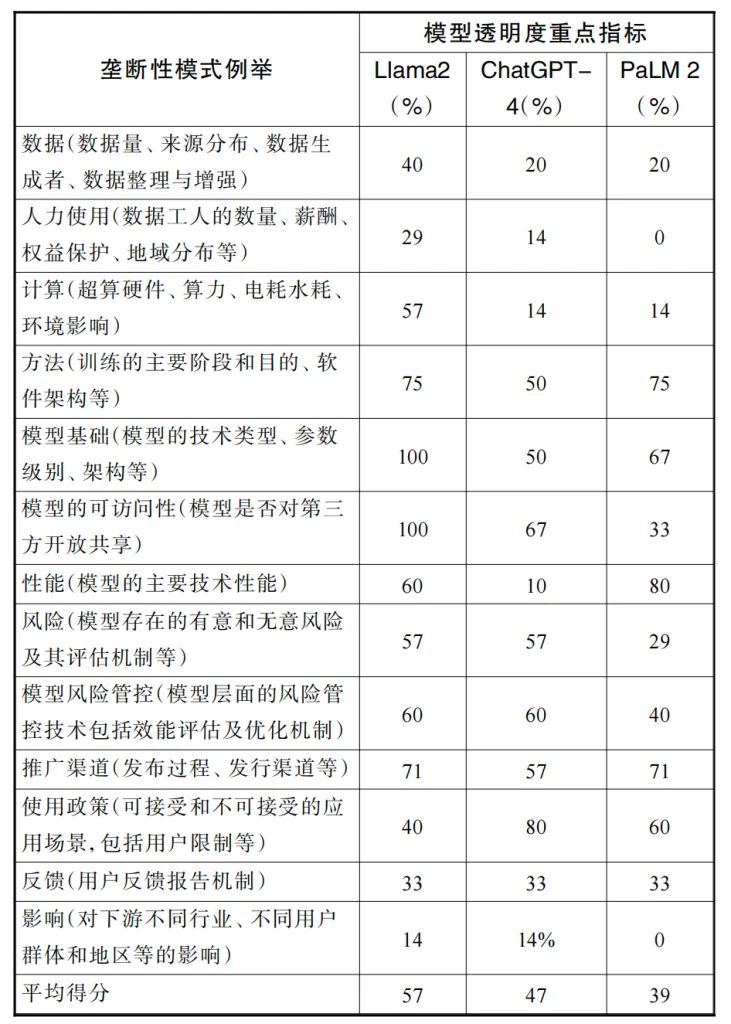
Los límites técnicos de la explicabilidad interactúan con la reticencia de los proveedores a revelar información relevante, lo que obstaculiza la evaluación, por reguladores e investigadores independientes, de riesgos deliberados y daños no intencionados. El Índice de Transparencia de los Modelos Fundacionales de Stanford (Bommasani, 2023) evalúa elementos técnicos importantes de los modelos principales. El artículo remite a una evaluación comparativa de unos diez grandes modelos y reproduce indicadores seleccionados de tres ejemplos destacados en la tabla 1. Sostiene que la opacidad de los modelos y los riesgos difíciles de detectar dificultan rastrear los errores y limitan su evaluación y prevención transparentes. Cita recomendaciones de expertos contrarias al uso de IA generativa para tareas de alto riesgo.
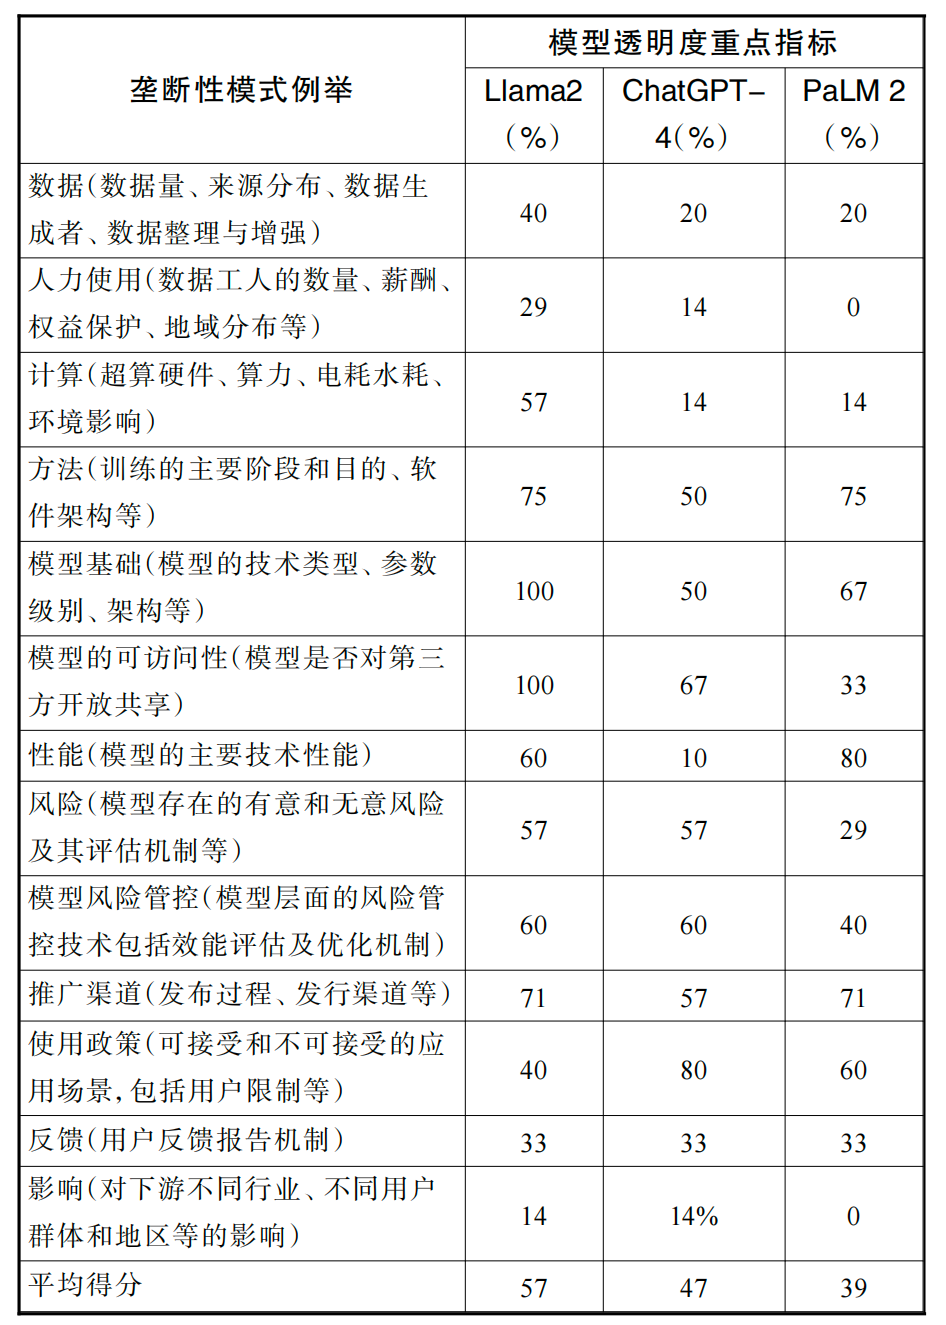
| Indicador | Llama 2 | ChatGPT-4 (denominación de la revista) | PaLM 2 |
|---|---|---|---|
| Datos: volumen, distribución de fuentes, productores, selección y enriquecimiento | 40 | 20 | 20 |
| Trabajo: número de trabajadores de datos, remuneración, derechos y distribución geográfica | 29 | 14 | 0 |
| Computación: hardware, capacidad, electricidad, agua y efectos ambientales | 57 | 14 | 14 |
| Métodos: etapas principales de entrenamiento, propósitos y arquitectura del software | 75 | 50 | 75 |
| Fundamentos del modelo: técnicas, escala de parámetros y arquitectura | 100 | 50 | 67 |
| Acceso al modelo: disponibilidad e intercambio con terceros | 100 | 67 | 33 |
| Rendimiento: principales capacidades técnicas | 60 | 10 | 80 |
| Riesgos: riesgos deliberados y no intencionados y mecanismos de evaluación | 57 | 57 | 29 |
| Mitigación de riesgos del modelo: evaluación y optimización | 60 | 60 | 40 |
| Distribución: proceso de publicación y canales | 71 | 57 | 71 |
| Políticas de uso: usos permitidos y prohibidos y restricciones para usuarios | 40 | 80 | 60 |
| Comentarios: mecanismos de notificación por los usuarios | 33 | 33 | 33 |
| Impacto: sectores derivados, grupos y regiones | 14 | 14 | 0 |
| Puntuación media impresa en el original | 57 | 47 | 39 |
5. Comprensión: semántica y mundo real
La IA generativa reconoce patrones contextuales de forma probabilística y produce texto según la sintaxis aprendida. El autor relaciona la comprensión semántica limitada con alucinaciones que contienen errores fácticos, históricos y científicos. Una clasificación histórica de Vectara alojada en GitHub, actualizada por última vez el 1 de noviembre de 2023, comunicaba tasas de alucinación específicas de la tarea del 3 %–3,5 % para los modelos GPT, del 5,1 %–5,9 % para Llama y del 12,1 % para Google PaLM. Se referían a la fidelidad de resúmenes de documentos, no a la exactitud de respuestas a preguntas generales. El artículo conjetura además que los errores en chino y otras lenguas serían mayores, pero esa clasificación no demuestra tal comparación entre lenguas.
Por ello, el alumnado sin conocimientos básicos sólidos puede aprender de contenidos inciertos durante conversaciones autónomas. El autor sostiene que estos sistemas no deberían tratarse como fuentes fiables de contenido docente. También distingue el procesamiento de patrones sintácticos de la comprensión de los objetos y relaciones del mundo real, de las relaciones humanas y sociales y de las relaciones de las personas con los objetos y las tecnologías. Señala que el descubrimiento científico depende de observar el mundo, experimentar y razonar, mientras que la IA generativa sintetiza principalmente bibliografía previa. En su exposición, el conocimiento nuevo requiere la capacidad de acción humana con la IA como apoyo.
El original infiere asimismo una conclusión sobre el «conocimiento» a partir de debates de derechos de autor; no deben confundirse la protección jurídica y la definición de conocimiento. Basándose en Candelon (2023), el artículo cuestiona también la capacidad de los modelos para producir soluciones específicas e innovadoras a desafíos complejos del mundo real o emitir juicios de valor social. Concluye que no deberían orientar de manera independiente el aprendizaje de conocimientos complejos ni la resolución de problemas poco estructurados sin docentes humanos.
Estas limitaciones, sostiene el autor, restringen una transformación educativa positiva en contenidos fundamentales, pensamiento de orden superior, resolución de problemas complejos, valores y desarrollo humano. La IA generativa puede influir en parte cuestionando desde fuera los resultados del aprendizaje y la evaluación: la automatización del procesamiento de contenidos y la dificultad para detectar la externalización debilitan el valor de la síntesis y la producción de bajo nivel como resultados centrales. Una menor presencia de ejercicios básicos de ortografía y sintaxis, informes de síntesis bibliográfica, elaboración de diapositivas y productos artísticos elementales en las evaluaciones formativas y de bajo impacto impulsaría a los sistemas a reconsiderar sus prioridades de aprendizaje y sus métodos de evaluación.
6. Contaminación por información generada: contenidos sintéticos en internet
El artículo identifica dos formas de contaminación derivadas de la producción y difusión de contenido de IA generativa.
Primero, los modelos pueden reproducir materiales dañinos aprendidos de internet, como desinformación, discriminación y discursos de odio, y volver a propagarlos en línea. Esta circulación repetida puede perjudicar al alumnado de distintas edades de maneras difíciles de revertir.
Segundo, una internet cada vez más poblada de materiales sintéticos afecta al entrenamiento de modelos posteriores. El aprendizaje profundo de calidad depende de datos diversos producidos por personas y de formas variadas de expresión de las que aprender distintos patrones. Cuando el contenido generado por máquinas vuelve a circular masivamente, los modelos posteriores pueden entrenarse con las salidas de modelos anteriores. En el proceso descrito, los sucesos de alta probabilidad quedan sobrerrepresentados y los de baja probabilidad, infrarrepresentados, eliminando gradualmente la cola larga estadística. Esa cola contribuye a conservar la exactitud y la diversidad.
Su pérdida puede reforzar patrones ya aprendidos y generar resultados cada vez más homogéneos, más próximos al material sintético que a la realidad, aumentar los errores y provocar potencialmente el colapso de los modelos. Esto añade dificultades para obtener datos de entrenamiento de calidad en internet (Lutkevich, 2023).
7. Proyección de valores: homogeneización y supresión lingüística y cultural
La proyección de valores similares mediante resultados generados puede suprimir a los grupos en desventaja digital, el pluralismo en la construcción educativa del conocimiento y la expresión de diferentes perspectivas.
Cuando una secuencia aparece frecuentemente en los datos de entrenamiento, un Transformer tiene más probabilidades de reproducirla y generar frases relacionadas. El artículo sostiene que las creencias comunes y las perspectivas de los medios dominantes en conjuntos de datos estadounidenses y europeos pueden convertirse en «respuestas estándar» del modelo, reforzando valores y convenciones lingüísticas o culturales ya poderosos mediante un bucle de retroalimentación. La adopción acrítica sin examinar el origen de los datos puede reforzar estereotipos culturales. Cita a Omiye (2023), cuyas pruebas repetidas de ChatGPT/GPT-3.5, GPT-4, Bard y Claude de Anthropic hallaron respuestas sesgadas que reproducían estereotipos raciales en preguntas sobre capacidad pulmonar, tasa de filtración glomerular estimada, grosor de la piel y tamaño cerebral.
Son ejemplos de sesgos dañinos de los modelos, no afirmaciones biológicas validadas. Por el contrario, los grupos marginados y pobres en datos dejan menos huellas en línea y están poco representados en los conjuntos de entrenamiento, por lo que sus valores y prácticas lingüísticas y culturales apenas se reconocen. El autor sostiene que los modelos pertinentes para los contextos locales y favorables a la diversidad son importantes para las lenguas y culturas indígenas y para los intereses legítimos de los grupos desfavorecidos (Miao, 2023).
La dependencia excesiva de la IA generativa para obtener «respuestas estándar» y soluciones también puede restringir las ideas y debilitar una innovación diversa. En el estudio de Boston Consulting Group citado, con más de 750 participantes, las ideas producidas con GPT-4 resultaron, según el estudio, un 41 % menos diversas que las producidas sin él. Los participantes mostraban a menudo poca inclinación a aumentar la diversidad tras recibir sugerencias del modelo. En la misma investigación, el 70 % manifestó preocupación por que el uso prolongado de la IA generativa para obtener respuestas erosionara la creatividad humana (Candelon, 2023). Estos resultados pertenecen al contexto de ese estudio.
8. Falsificaciones sintéticas ilícitas: mayor facilidad de creación y difusión
La IA generativa reduce las barreras de conocimientos y costes para producir falsificaciones sintéticas ilícitas y dificulta su detección, facilitando su creación y circulación.
El artículo explica cómo personas sin conocimientos de periodismo, música o producción de vídeo pueden utilizar contenido sintético para suplantar a personas reales, difundir noticias falsas u odio, difamar, manipular imágenes y vídeos existentes o perseguir otros fines ilícitos. El autor contrapone los beneficios inciertos para resolver problemas de interés público a la accesibilidad de herramientas para usos maliciosos. El informe citado, State of Deepfakes de 2023 (Home Security Heroes, actualmente Security Hero), afirmaba que se podía generar gratuitamente una falsificación sexual explícita de sesenta segundos a partir de una imagen clara del rostro en menos de veinticinco minutos.
El informe analizó 95.820 vídeos y describió un crecimiento del 550 % respecto de 2019; se corrigen frente a esa fuente las afirmaciones originales de «casi un millón de vídeos nuevos» y «5,5 veces». Estas cifras corresponden a la investigación del informe y no a un censo mundial verificado ni a un total actual. Indicaba que el 98 % de los vídeos sintéticos examinados eran pornográficos y que el 99 % de las personas representadas en esa categoría eran mujeres.
III. Recomendaciones para la regulación
Para abordar estas controversias y desarrollar al mismo tiempo el potencial educativo, la Guía propone principios centrados en el ser humano para desarrollar y utilizar la IA. Su vía de «priorizar la regulación, garantizar la inclusión y orientar las aplicaciones» persigue un uso ético, seguro, fiable, equitativo, inclusivo y significativo.
1. Un enfoque centrado en el ser humano para la gobernanza y la aplicación de la IA
Desde 2019, la UNESCO ha defendido una investigación y aplicación de la IA centradas en el ser humano, desarrolladas en documentos como la Recomendación sobre la ética de la inteligencia artificial (citada como UNESCO, 2022), el Consenso de Beijing sobre la inteligencia artificial y la educación (UNESCO, 2019) e Inteligencia artificial y educación: Guía para las personas a cargo de formular políticas (citada como Miao, 2022). Según esta exposición, la gobernanza y el uso deben proteger los derechos fundamentales, la dignidad y la diversidad cultural, junto con una comprensión biocéntrica de las relaciones armoniosas entre las personas, sus entornos y los ecosistemas. El desarrollo debe estar al servicio de las personas y fortalecer sus capacidades de cooperación eficaz con las máquinas.
A lo largo del diseño, el desarrollo, el uso y la iteración, la capacidad de acción humana debe ocupar un lugar central, con fiabilidad, adecuación a las personas y a los propósitos, explicabilidad, control humano y responsabilidad humana (Miao, 2022).
2. Una hoja de ruta para la gobernanza de la IA generativa
La Guía recomienda una gobernanza colaborativa del conjunto del gobierno que especifique los derechos, las facultades, las responsabilidades y las obligaciones de los actores de distintos sectores y actividades.
2.1 Negociar instrumentos internacionales, incluidas reglas de protección transfronteriza de los datos
Se proponen reglas de protección de datos mutuamente reconocidas y mecanismos de gobernanza transfronteriza como condiciones previas para abordar las lagunas jurisdiccionales. El RGPD ofrece un ejemplo de marco jurídico para gobernar servicios transfronterizos basados en datos.
2.2 Establecer estrategias de IA del conjunto del gobierno y una gobernanza ética intersectorial
Una estrategia del conjunto del gobierno puede coordinar la gobernanza de la IA entre sectores y departamentos. Los mecanismos de gobernanza ética deberían aclarar la soberanía nacional sobre los datos; los derechos y la privacidad de las instituciones y las personas; las relaciones lícitas en la producción de datos; los principios centrales del desarrollo y el uso de la IA; y la distribución del valor excedente de productos de IA construidos con datos públicos o de otras personas.
2.3 Elaborar normas que aborden específicamente la IA generativa
China publicó las Medidas provisionales para la gestión de los servicios de inteligencia artificial generativa en julio de 2023. El autor las describió como las primeras reglas formales del mundo para la gobernanza jurisdiccional de servicios de IA generativa, una valoración comparativa formulada en el contexto histórico del original. Propuso perfeccionar sus disposiciones jurídicas y éticas a partir de la Guía y de las iniciativas europeas y estadounidenses de entonces. Los siguientes puntos eran especialmente pertinentes para la educación:
1. Clasificar los riesgos de seguridad técnica y regular según su nivel. La exposición del artículo sobre el proyecto europeo de Reglamento de IA entonces debatido distingue riesgos inaceptables, incluidas tecnologías que manipulan a menores para crear dependencia, reconocimiento de emociones y determinadas predicciones de inteligencia o comportamiento; riesgos altos; riesgos limitados; y riesgos mínimos. Describe enfoques que van desde prohibir el desarrollo y la comercialización hasta la supervisión intensa, la revisión y el control, y la autorregulación sectorial. Se identificaba la educación como ámbito de especial vigilancia. Son las categorías discutidas en el texto histórico, no una descripción de todas las disposiciones de la norma posteriormente adoptada.
2. Establecer salvaguardias de edad para conversar de forma autónoma con IA generativa. Como los modelos conversacionales pueden generar material inadecuado para menores, la Guía recomienda trece años como umbral mínimo de uso autónomo, al tiempo que considera un umbral más estricto de dieciséis. Al pasar los servicios de conversaciones en plataformas a aplicaciones en dispositivos personales, los reguladores y los adultos pueden tener más dificultades para supervisar el uso independiente. El autor pide evaluar estos riesgos y aclarar las responsabilidades de supervisión del uso por menores. La referencia final a «adultos» del párrafo original se corrige por contexto a «menores». Los trece y dieciséis años son recomendaciones discutidas, no una edad legal universal para conversar con IA.
3. Aclarar las responsabilidades de los demás actores. El artículo contrapone las Medidas chinas, centradas en los proveedores, a las responsabilidades institucionales más amplias descritas en la orden ejecutiva estadounidense de 2023. Propone obligaciones para las instituciones que adquieren e implantan sistemas de IA: comprobar conjuntamente la legalidad de los datos, las herramientas y los servicios de contenido, y contribuir a vigilar los efectos cambiantes sobre los usuarios, especialmente los grupos desfavorecidos. Una vez aclaradas las responsabilidades institucionales, también deberían considerarse las obligaciones de los usuarios individuales, incluidas la conciencia y las competencias para reconocer amenazas y protegerse, y los conocimientos y capacidades para utilizar lícitamente las herramientas y el material generado.
4. Aclarar la identificación, los derechos de autor y los usos permitidos del contenido generado. Las Medidas chinas exigen a los proveedores etiquetar las imágenes y los vídeos generados conforme a las reglas que rigen los servicios de información en internet de síntesis profunda. El original atribuye también el etiquetado de contenido de IA al RGPD; hay que distinguir la legislación de protección de datos de las normas de transparencia de la IA, como explican las notas editoriales. El autor sostiene que los tres marcos de entonces examinados no resolvían todas las cuestiones de uso legítimo de los productos generados.
Quedaban pendientes limitar las falsificaciones sintéticas ilícitas; definir y proteger los derechos de usuarios de pago sobre el material generado; y distinguir la síntesis bibliográfica asistida por IA dentro de una investigación dirigida por personas de las trampas que vulneran la ética académica o las normas docentes.
IV. Recomendaciones de política y práctica para el uso educativo
La Guía ofrece recomendaciones detalladas para aplicaciones educativas eficaces. El artículo destaca las siguientes:
1. Garantizar la inclusión, la equidad y la diversidad lingüística y cultural
La relación entre la IA generativa y los principios centrados en el ser humano tiene cuatro implicaciones. Primero, el acceso y las oportunidades equitativos son condiciones previas para promover la inclusión educativa: las personas deben tener oportunidades con independencia del género, la etnia, las capacidades, la situación socioeconómica o la residencia fija. Los países deberían utilizar la clasificación propuesta de causas de la pobreza de datos para identificar a los grupos excluidos y abordar carencias concretas. Segundo, una financiación específica debería apoyar herramientas para personas de diferentes capacidades y edades que aprenden a lo largo de la vida, incluidas aquellas con necesidades especiales de aprendizaje.
Tercero, la evaluación debería examinar sesgos en las fuentes de datos, el preprocesamiento, el diseño de los modelos y sus resultados, como los sesgos de género, los estereotipos sobre grupos específicos, la discriminación contra personas marginadas y los discursos de odio. Cuarto, los indicadores de diversidad lingüística y cultural deberían apoyar las lenguas minoritarias e indígenas mediante los datos de preentrenamiento, las arquitecturas y los métodos de entrenamiento, evitando su exclusión o la introducción de filtros y posprocesamientos sesgados.
2. Proteger la capacidad de acción humana
A medida que aumenta la capacidad de la IA generativa y se automatiza parcialmente el procesamiento elemental de contenidos, su uso educativo puede debilitar la capacidad de acción. La facilidad para producir redacciones u obras artísticas básicas puede fomentar la dependencia de contenido generado externamente y reducir las oportunidades para ejercitar la mente y desarrollar conocimientos y capacidades fundamentales. Por tanto, proteger y fortalecer esa capacidad debería ser central en el diseño y la adopción: la IA puede desafiar y ampliar el pensamiento humano, pero no debe usurparlo. La Guía propone siete salvaguardias. Primero, explicar qué datos del alumnado se recopilan, cómo se utilizan y sus posibles efectos en la vida educativa y social.
Segundo, proteger la motivación intrínseca y la autonomía humana en decisiones y acciones de enseñanza y aprendizaje apoyadas por IA. Tercero, preservar oportunidades para desarrollar capacidades cognitivas y sociales mediante la observación de la realidad, métodos empíricos como experimentos y debates, y razonamiento lógico. Cuarto, garantizar la interacción social y el contacto con obras de creación humana, evitando la dependencia excesiva o la adicción. Quinto, consultar a investigadores, docentes y estudiantes antes de una adopción a gran escala. Sexto, fomentar el cuestionamiento de los métodos técnicos, la exactitud, los valores incorporados y los efectos pedagógicos. Séptimo, docentes y estudiantes deben conservar la responsabilidad por las decisiones adoptadas con asistencia de IA.
3. Revisar y supervisar las herramientas educativas de IA y desarrollar modelos fundacionales adecuados al contexto local
La ética desde el diseño y un enfoque de ciclo de vida deberían orientar el desarrollo y la implantación, protegiendo al alumnado, al profesorado y las relaciones educativas de riesgos técnicos o éticos previsibles y de herramientas inadecuadas. Para los sistemas existentes, la Guía recomienda revisión, autorización y seguimiento continuo. Los controles éticos deberían examinar la reducción de sesgos, especialmente de género, y la representatividad lingüística y cultural de los datos. Antes de su aprobación, los sistemas deberían evitar daños previsibles, demostrar valor educativo, adecuarse a la edad y las capacidades del alumnado y ajustarse a los principios institucionales sobre conocimientos, competencias, resultados previstos y valores.
El uso de datos y la autorización de servicios requieren información comprensible sobre los riesgos, los acuerdos de tutela aplicables, comunicación apropiada a la edad, accesibilidad y consentimiento válido. La discapacidad por sí sola no determina la capacidad jurídica; las notas editoriales explican la corrección de la clasificación general del original a partir del artículo 12 de la Convención sobre los Derechos de las Personas con Discapacidad. Las revisiones también deberían comprobar la presencia de falsificaciones sintéticas, noticias falsas, discursos de odio y otros resultados dañinos o ilícitos, y examinar los costes ambientales, incluida la electricidad y el agua empleadas para entrenar modelos, en el contexto local.
El artículo identifica carencias en la adecuación cultural y lingüística de los modelos entonces dominantes fuera de Estados Unidos y Europa. Respetando la competencia internacional lícita, recomienda un desarrollo activo para mejorar la idoneidad local: apoyar modelos fundacionales nacionales seguros y controlables con acuerdos apropiados sobre derechos; desarrollar y probar iterativamente transformadores generativos preentrenados para la educación, o modelos EdGPT, basados en valores locales, diversidad lingüística y cultural y estándares curriculares; y crear incentivos para plataformas y complementos que apoyen la indagación y diferentes opciones de aprendizaje.
El objetivo es un ecosistema en el que los modelos fundacionales y las aplicaciones educativas derivadas se desarrollen conjuntamente en torno a las lenguas, culturas y currículos locales.
4. Desarrollar las competencias en IA de docentes y estudiantes
Las competencias en IA, especialmente para el alumnado escolar, son esenciales para un uso seguro, ético y significativo. El artículo señala que a mediados de 2022 solo unos quince países tenían currículos escolares de IA respaldados a escala nacional (UNESCO, 2022), lo que hacía cada vez más urgente una alfabetización básica universal en IA. El marco para estudiantes entonces en desarrollo organizaba competencias por dimensiones y niveles, combinando aprendizaje en el aula y extraescolar. Sus dimensiones eran una mentalidad de IA centrada en el ser humano, la ética de la IA, las técnicas y aplicaciones fundamentales y el diseño de sistemas de IA. Los niveles de comprensión, aplicación y creación describían conocimientos, capacidades y actitudes. La tabla 2 conserva ese borrador histórico.
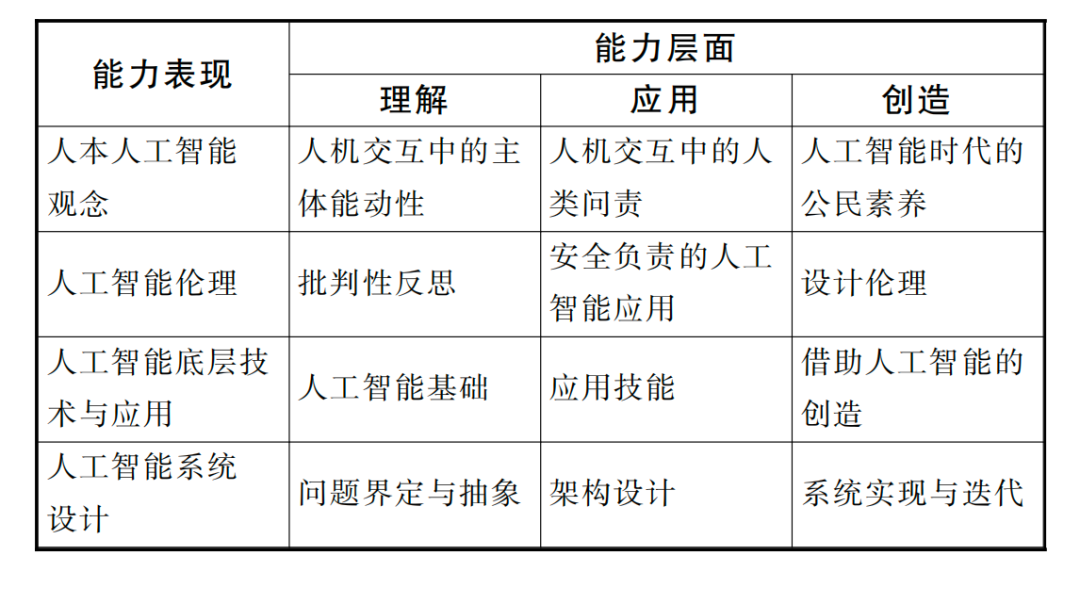
| Dimensión de competencia | Comprender | Aplicar | Crear |
|---|---|---|---|
| Mentalidad de IA centrada en el ser humano | Capacidad de acción en la interacción entre personas e IA | Responsabilidad humana en la interacción entre personas e IA | Ciudadanía en la era de la IA |
| Ética de la IA | Reflexión crítica | Uso seguro y responsable de la IA | Ética desde el diseño |
| Fundamentos y aplicaciones de IA | Fundamentos de IA | Competencias de aplicación | Creación con IA |
| Diseño de sistemas de IA | Definición y abstracción del problema | Diseño de arquitectura | Implementación e iteración |
La UNESCO también elaboraba un marco para docentes destinado a orientar estándares y formación nacionales para un uso apropiado, que aparece en la tabla 3 como borrador histórico original. Sus cinco dimensiones eran una mentalidad de IA centrada en el ser humano, la ética de la IA, los fundamentos y aplicaciones, la integración de IA y pedagogía y el desarrollo profesional apoyado por IA. Tres niveles —adquisición, profundización y creación— describían resultados para docentes con distintos puntos de partida. La adquisición se dirigía a todo el profesorado tras la formación, incluido el que carecía de preparación previa en IA y el de entornos con pocos recursos. La profundización se orientaba a docentes con conocimientos y experiencia intermedios.
La creación aspiraba a un desempeño experto entre docentes con amplios conocimientos y experiencia de aplicación de IA.
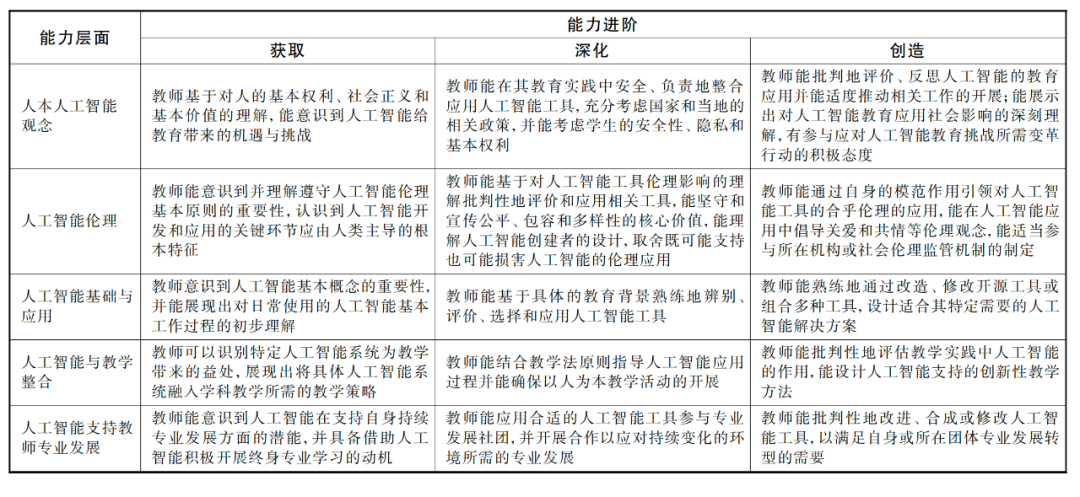
| Dimensión de competencia | Adquirir | Profundizar | Crear |
|---|---|---|---|
| Mentalidad de IA centrada en el ser humano | Reconocer las oportunidades y los desafíos educativos de la IA a partir de una comprensión de los derechos fundamentales, la justicia social y los valores básicos. | Integrar herramientas de IA de forma segura y responsable en la práctica educativa, considerando las políticas nacionales y locales y la seguridad, la privacidad y los derechos fundamentales del alumnado. | Evaluar y reflexionar críticamente sobre la IA educativa, impulsar de manera apropiada el trabajo relacionado, comprender sus efectos sociales y participar positivamente en los cambios necesarios para afrontar los desafíos. |
| Ética de la IA | Comprender la importancia de los principios éticos y reconocer las consideraciones centradas en el ser humano a lo largo del desarrollo y el uso. | Evaluar y adaptar críticamente las herramientas según sus efectos éticos; defender la equidad, la inclusión y la diversidad y comprender cómo los diseños y las decisiones de compromiso de los desarrolladores pueden favorecer o perjudicar una aplicación ética. | Dar ejemplo de uso ético, promover y compartir ideas éticas y participar en el establecimiento de supervisión de la ética de IA en las instituciones o en la sociedad. |
| Fundamentos y aplicaciones de IA | Reconocer los conceptos básicos importantes y demostrar una comprensión inicial del funcionamiento de las herramientas cotidianas de IA. | Identificar, evaluar, seleccionar y utilizar herramientas de manera competente en contextos educativos específicos. | Seleccionar o desarrollar y adaptar herramientas de código abierto, o combinar herramientas, para diseñar soluciones de IA para necesidades concretas. |
| Integración de IA y pedagogía | Identificar los beneficios docentes de un sistema y demostrar estrategias para integrarlo en la enseñanza de una materia. | Orientar las aplicaciones de IA mediante principios pedagógicos y garantizar actividades de aprendizaje centradas en el ser humano. | Evaluar críticamente el papel de la IA en la práctica docente y diseñar pedagogías innovadoras apoyadas por IA. |
| Desarrollo profesional apoyado por IA | Reconocer el potencial de la IA para el desarrollo profesional continuo y mantener la motivación para un aprendizaje profesional a lo largo de la vida con su apoyo. | Utilizar herramientas apropiadas para participar en comunidades profesionales y colaborar en el desarrollo dentro de entornos cambiantes. | Adaptar, combinar o modificar críticamente herramientas para responder a necesidades de desarrollo profesional personales o de la comunidad. |
5. Fomentar una enseñanza creativa, una construcción plural del conocimiento y una expresión diversa
La educación sostiene la civilización y su desarrollo continuo mediante la diversidad lingüística y cultural, la construcción individual de significado y las diversas formas de expresión. El autor sostiene que reproducir las visiones del mundo de los propietarios de los datos de entrenamiento puede suprimir perspectivas alternativas y amenazar esa misión. Por ello, la IA generativa no debería tratarse como fuente autorizada de conocimiento en ninguna materia. Docentes y estudiantes deberían evaluar críticamente sus resultados, reconociendo su utilidad para recuperar información rápidamente, buscar bibliografía y convertir formatos, pero previendo contenidos poco fiables.
La enseñanza debería adecuarse al alumnado, animándolo a evaluar los valores proyectados y los supuestos culturales y a utilizar la síntesis bibliográfica y el procesamiento de datos para indagar. El alumnado necesita también suficientes oportunidades de ensayo y error sin IA, experimentación empírica y observación del mundo real.
6. Examinar los efectos educativos a largo plazo entre disciplinas y sectores
Aunque el estudio reconstruye procesos y limitaciones conocidos, los modelos fundacionales y las aplicaciones derivadas, en rápida evolución, interactúan con situaciones educativas muy variadas e inciertas. Su importancia educativa no debería evaluarse de forma estrecha a partir de defectos actuales o desde una postura exclusivamente escéptica. La Guía pide la colaboración de investigadores y proveedores de IA, teóricos de la educación, investigadores de neurociencia cognitiva y otros campos, docentes, estudiantes y familias.
Deberían examinar conjuntamente los efectos a largo plazo sobre la producción y el aprendizaje del conocimiento, los derechos de autor y la investigación, los currículos y la evaluación, la cooperación humana y el desarrollo social, para después reconsiderar con cuidado los marcos curriculares, los objetivos educativos y los exámenes y realizar ajustes apropiados a escala del sistema.
Evaluar el potencial educativo de un gran avance tecnológico en el procesamiento de contenidos no debería empezar y terminar en las afirmaciones comerciales o las ganancias de productividad al crear contenido. El punto de partida sigue siendo los principios centrados en el ser humano. Los educadores deberían examinar las controversias a lo largo de todo el ciclo de vida de la IA y abordar sus implicaciones para la equidad, la inclusión, los valores y la diversidad lingüística y cultural. Según la conclusión del autor, esto es necesario para evitar que las personas y las comunidades, como participantes y beneficiarias de la educación, se conviertan en sujetos de experimentación o servidoras de una IA impulsada comercialmente.
Referencias
- Bishop, J. M.(2021). Artificial Intelligence is stupid and causal reasoning won't fix it[J]. Frontier in Psychology, 2021(11):1-18.
- Bommasani, R., Hudson, D. A., Adeli, E., et al (2021). On the opportunities and risks of foundation models[DB/OL]. [2023-10-16]. https://crfm.stanford.edu/report.html.
- Bommasani, R., Klyman, K., Longpre, S. et al.(2023). The foundation model transparency index.[DB/OL]. [2023-10-10]. https://arxiv.org/abs/2310.12941.
- Candelon, F., Krayer, L., Rajendran,S. et al.(2023). How people can create and destroy value with generative AI[DB/OL]. [2023.10-12]. https://www.bcg.com/publications/2023/how-people-create-and-destroy-value-with-gen-ai.
- European Parliament(2023). MEPs ready to negotiate first-ever rules for safe and transparent Al. [DB/OL. [2023-10-18]. https://digital-strategy.ec.europa.eu/en/policies/european-approach-artificial-intelligence.
- European Union(2016). General Data Protection Regulation[DB/OL].[2023-08-09]. http://data.europa.eu/eli/reg/2016/679/oj.
- GitHub(2023). Hallucination Leaderboard. [DB/OL]. [2023-11-08]. https://github.com/vectara/hallucination-leaderboard.
- Home Security Hero(2023). State of deepfakes: Realities,threats, and impact [DB/OL].[2023-11-11]. https://www.homesecurity-heroes.com/state-of-deepfakes/#key-findings.
- Lin, B.(2023). Al is generating security risks faster than companies can keep pp.[DB/OL].[2023-08-25]. https://www.wsj.com/articles/ai-is-generating-security-risks-faster-thancompanies-can-keep-up-a2bdedd4.
- Lutkevich, B.(2023). Model collapse explained: How synthetic training data breaks AI [DB/OL].[2023-10-28]. https://www.techtarget.com/whatis/feature/Model-collapse-explained-How-synthetic-training-data-breaks-AI.
- Marwala, T(2023). Algorithm Bias: Synthetic Data Should Be Option of Last Resort When Training Al Systems.[DB/OL]. [2023-07-31].https://unu.edu/article/algorithm-bias-synthetic-data-should-be-option-last-resort-when-training-ai-systems.
- Miao, F.(2022). Al and education: Guidance for policymakers|M]. Paris, UNESCO.
- Miao, F.et al(2023). Guidance on generative Al in education and research [M]. Paris: UNESCO 2023.
- 苗逢春(2022). 教育人工智能伦理的解析与治理: 人工智能伦理问题建议书的教育解读[J].中国电化教育,2022(6):22-36.
- 苗逢春(2023). 数字文明变局中的教育数字化转型[J].电化教育研究,(2):47-63,91.
- Omiye, J. A., Lester, J.C., Spichak, S. et al.(2023). Large language models propagate race-based medicine[J]. Digital Medicine, 2023(6):195:1-4.
- Pearl, J.,& Mackenzie, D.(2018). The book of why: The new science of cause and effect [M]. NY: Basic Books.
- Robertson, K.(2023). News group says A. I. Chatbots heavily rely on news content [EB/OL]. The New York Times. https://www.nytimes.com/2023/10/31/business/media/news-artificial-intelligence-chatbots.html.
- Stanford University(2019). The 2019 Al Index Report[DB/OL].[2023-1018]. https://hai.stanford.edu/ai-index-2019.
- The White House(2023). Executive order on the safe, secure, and trustworthy development and use of artificial intelligence [OL] The White House. https://www.whitehouse.gov/briefing-room/presidential-actions/2023/10/30/executive-order-on-the-safe-secure-and-trustworthy-development-and-use-of-artificial-intelligence/.
- Thompson, A. D.(2023). Contents of GPT-3 & the pile v1[EB/OL].[2023-1018]. https://lifearchitect.ai/models/#gpt-3-top-10.
- Touvron H, Martin, L, Stone, K et al.(2023) Llama 2: Open foundation and fine-tuned chat models[DB/OL][2023-10-16]. https://ai.meta.com/research/publications/llama-2-open-foundation-and-fine-tuned-chat-models.
- UNCTAD(2023). Data protection and privacy legislation worldwide [DB/OL].[2023-07-18]. https://unctad.org/page/data-protection-and-privacy-legislation-worldwide.
- UNESCO(2019). Beijing consensus on artificial intelligence and education[S].Paris, UNESCO.
- UNESCO(2022). Recommendation on the Ethics of Artificial Intelligence[S]. Paris, UNESCO.
- Zhang, D., Finckenberg-Broman, P., Hoang, T., et al(2023). Right to be forgotten in the era of large language models: Implications, challenges, and solutions [DB/OL]. arXiv: 2307.03941v3 [cs.CY]22 Sep 2023.
- 中共中央、国务院(2022). 关于构建数据基础制度更好发挥数据要素作用的意见 [EB/OL].[2023-10-23]. https://www.gov.cn/zhengce/2022-12/19/content_5732695.htm.
Metadatos originales de la revista en inglés (archivo)
Generative AI and its Uses in Education: Foundational Controversies and Responding Strategies
MIAO Fengchun 1,2
1. National Engineering Laboratory for Cyberlearning and Intelligent Technology, Faculty of Education, Beijing Normal University,
2. Headquarters of UNESCO
Abstract: The paper is the second edition of a serials of interpretative articles on the Guidance on generative AI in education and research released by UNESCO, and the main aim of this edition is to examine the controversies around generative AI and its use in education. Based on an analysis of how it works, the development and deployment of generative AI have triggered the following controversies: worsening digital poverties, outpacing domestic governance, the collection of pre-training data without consent, the unexplainability of the architecture, the foundational models can't under the real world, the outputs of generative AI is polluting the internet, the outputs are projecting dominant values, amplifying the creation and dissemination of illegal deepfakes. Generative AI poses direct and most profound threats on the core values of education including inclusion, equity, cultural and linguistic diversities, pluralism in knowledge construction and expression, and therefore, those core values should be upheld as the logic base when examining the proportionality of generative AI to service purposes of education. Policy-makers and practitioners should follow the logic roadmap of "prioritizing regulation, ensuring inclusion, and guiding applications" to enhance the system-wide governance regulations in order to ensure trustable, self-automatic, and locally relevant eco-systems of generative AI for education, followed by developing capacities and guidance to steer proper uses of generative AI in education.
Keywords: generative AI;content processing across symbolic representations of human thinking;sources of pre-training datasets;equity, inclusion, cultural and linguistic diversities
Notas editoriales y fuentes de verificación
- Fechas de publicación: la revista indica febrero de 2024, volumen 30, número 1, páginas 4–15, DOI 10.13966/j.cnki.kfjyyj.2024.01.001. Se conserva por separado la fecha original del archivo del sitio, el 27 de enero de 2024. Artículo original; DOI; Número de la revista
- Denominaciones técnicas: el ChatGPT lanzado el 30 de noviembre de 2022 utilizaba inicialmente la serie GPT-3.5. Un token no equivale necesariamente a un byte. Stanford desarrolló Alpaca mediante el ajuste fino de LLaMA 7B de Meta; el original atribuía erróneamente Alpaca a Meta. Estas denominaciones se han corregido. Lanzamiento de ChatGPT; Alpaca de Stanford
- Escala de modelos y datos de entrenamiento: la afirmación original de «1,8 billones» de parámetros para GPT-4 no fue confirmada en el informe técnico oficial, que no reveló el tamaño del modelo. Las estimaciones del corpus de GPT-3, sus proporciones de fuentes y lenguas y las cifras de computación de 2012–2019 se conservan como material histórico atribuido, no como descripciones del ChatGPT inicial o de modelos posteriores. Informe técnico de GPT-4
- Regulación histórica: el 9 de diciembre de 2023 se alcanzó un acuerdo político provisional en la UE; el Reglamento de IA formal es legislación de 2024. El nombre completo de la norma china es Medidas provisionales para la gestión de los servicios de inteligencia artificial generativa; se anunció el 13 de julio de 2023 y entró en vigor el 15 de agosto. Las propuestas de modificación y las comparaciones con la orden estadounidense siguen siendo análisis históricos. Acuerdo de la UE de 2023; Reglamento de IA de la UE de 2024; Texto original de la CAC
- Edad y etiquetado: los trece y dieciséis años son recomendaciones discutidas en el texto, no edades legales universales para conversar con IA. El artículo 8 del RGPD trata del consentimiento infantil al tratamiento de datos en determinadas condiciones. La referencia final a «adultos» del párrafo original se corrige a «menores». Deben distinguirse los requisitos de etiquetado o transparencia del artículo 12 de las Medidas chinas y del artículo 50 del Reglamento de IA de la UE de 2024 de las reglas de protección de datos del RGPD. RGPD; Texto original de la CAC; Reglamento de IA de la UE de 2024
- Desaprendizaje: la afirmación original de imposibilidad es demasiado absoluta. La versión citada de Zhang y colaboradores, del 22 de septiembre de 2023, aborda la privacidad diferencial, el desaprendizaje automático, la edición de modelos y la ingeniería de instrucciones. Se conserva el problema de eliminar la influencia de los datos, junto con estas vías técnicas y sus dificultades de implementación. Estudio citado de 2023
- Tasas de alucinación: los porcentajes citados corresponden a la tarea histórica de fidelidad de resúmenes de Vectara. La versión del 1 de noviembre de 2023 utilizó 831 documentos resumidos por todos los modelos comparados. No son tasas de error en preguntas generales ni demuestran tasas de error en chino. Se enlaza una revisión histórica fija en lugar de la clasificación actual, que cambia continuamente. Clasificación histórica de Vectara
- Estadísticas de falsificaciones sintéticas: el informe sectorial citado analizó 95.820 vídeos y describió un crecimiento del 550 % desde 2019. La afirmación original de «casi un millón de vídeos nuevos» contradice esa fuente; «5,5 veces» no debe equipararse con un porcentaje de crecimiento. Los resultados del 98 % y el 99 % mantienen su atribución a la investigación del informe y no se presentan como un censo mundial ni como cifras actuales. Informe de falsificaciones sintéticas de 2023
- Discapacidad y autorización: el original agrupaba de manera general a menores y personas con discapacidad como carentes de plena «capacidad penal», lo que no constituye una regla general válida de autorización. Esta edición distingue la tutela aplicable, la información adecuada a la edad, la accesibilidad, el apoyo a la toma de decisiones y el consentimiento válido. El artículo 12 de la Convención sobre los Derechos de las Personas con Discapacidad reconoce la igualdad de capacidad jurídica y los apoyos y salvaguardias necesarios para ejercerla. Convención sobre los Derechos de las Personas con Discapacidad
- Marcos y juicios de investigación: las tablas 2 y 3 conservan los borradores en desarrollo al redactarse el artículo; los marcos posteriores de 2024 se presentan en otra noticia. Las afirmaciones sobre comprensión, conocimiento, derechos de autor y creatividad son argumentos del autor en aquel momento. Las estadísticas y los resultados comparativos pertenecen al alcance de los estudios originales. Artículo original
Fuente: Miao, Fengchun (2024), Generative AI and its Uses in Education: Foundational Controversies and Responding Strategies, Open Education Research, 30(1), 4–15. Las afiliaciones y los metadatos originales en inglés se conservan del archivo. Los derechos correspondientes pertenecen a la revista y a los autores.
Investigaciones y recursos relacionados
Otras lecturas: guía de la UNESCO sobre IA generativa; primer artículo sobre la idoneidad educativa; noticia sobre los marcos de competencias en IA de 2024 para docentes y estudiantes; recursos de educación especial e inclusiva.
Enlace original: https://aiedchair.bnu.edu.cn/news-6398-es/